⚠️ **블로그 컨셉상 반어체가 들어가니 양해바랍니다
**
🤖 AI와 GPU 그리고 Local LLM(소버린 AI) PART 1
이번에는 서버맨의 전공까지는 아니지만,
나름 대학원에서 데이터마이닝 I, II 수업을 각각 B-, B+ 을 받은 경험을 살려 (증거는 생략한다!)
AI, GPU, 그리고 한창 떠들고 있는 소버린 AI 에 대해 다뤄보려 한다. 😤
📋 이번 포스팅 구성
이번 포스트는 크게 3 PART로 구성될 예정이다.
| PART 1 | AI 개념 털기 👈 지금 여기 |
| PART 2 | LLM 추론 프레임워크 (Ollama) 구축 및 환경 설정 |
| PART 3 | 구축된 Local LLM으로 비서(OpenClaw), Open WebUI, 나만의 LLM API 사용해보기 |
아마 상당한 양의 포스팅 분량이 될 것 같다. 천천히 시작해보자 🚀
🧩 AI 분류 — 생각보다 훨씬 넓다
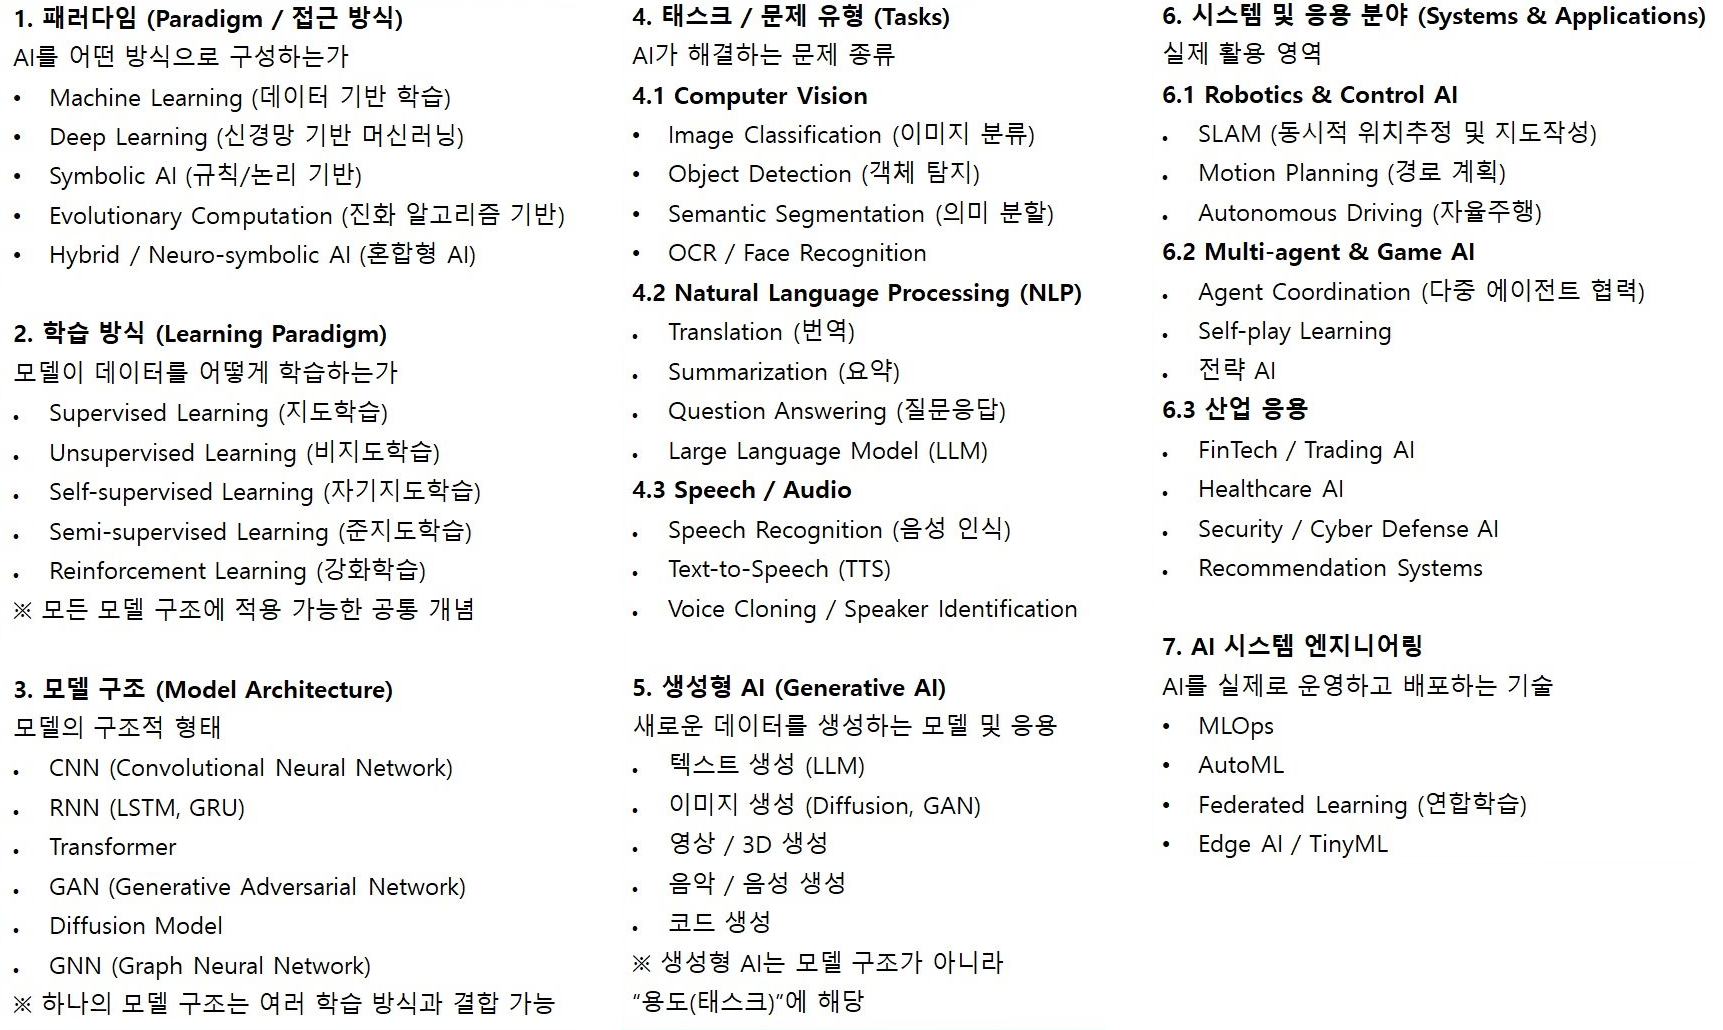
오늘 포스팅에서는 로컬 LLM이 왜 필요한지에 대해 알아보겠다.
⚠️ AI는 정말 어려운 분야다. 위의 분류 말고도 더 있고, 앞으로도 계속 나오고 있다.
사실 블록체인도 이 정도 급으로 복잡하다.(진짜 깊게들어가면 꽤 복잡함)
하지만 블록체인은 인기가 없고, AI는 폭발적인 인기가 있는 이유는 딱 하나다.
💡 '몰라도' 쓸 수 있게 만드냐의 차이
서버맨은 블록체인을 정말 좋아하고, 전공자로서 어떻게든 대중화를 시키기 위해
'몰라도' 쓸 수 있게 만들어보고 싶었지만...
사실 그 역할은 거래소가 다 하고 있음에도 일반 사람들에게 여전히 '어렵다'.
반면 몰라도 쓸 수 있고, 뭐든지 다 대답해주고, 알아서 다 하는 AI는 인기가 있을 수밖에 없는 게 당연하다. 😭
🧠 LLM이란? — 우리가 쓰는 AI의 정체
보통의 사람들에게 AI는 곧 ChatGPT 로 인식된다. 하지만 진성 CS 공학인이라면 정확하게 알아야겠다.
우리가 보통 쓰는 ChatGPT, Claude, Gemini 등은 Large Language Model, 즉 라지 랭기지 모델(LLM) 이다.
위 분류 표에서 모델구조 → 트랜스포머 에 해당한다고만 그냥 살짝 그런 게 있다라고만 알아두자.
문제는 이 L(Large) — 크다는 개념이 우리 생각과는 차원이 다른 수준이라는 거다.
📦 모델의 크기 — 도대체 몇 B(Billion)?
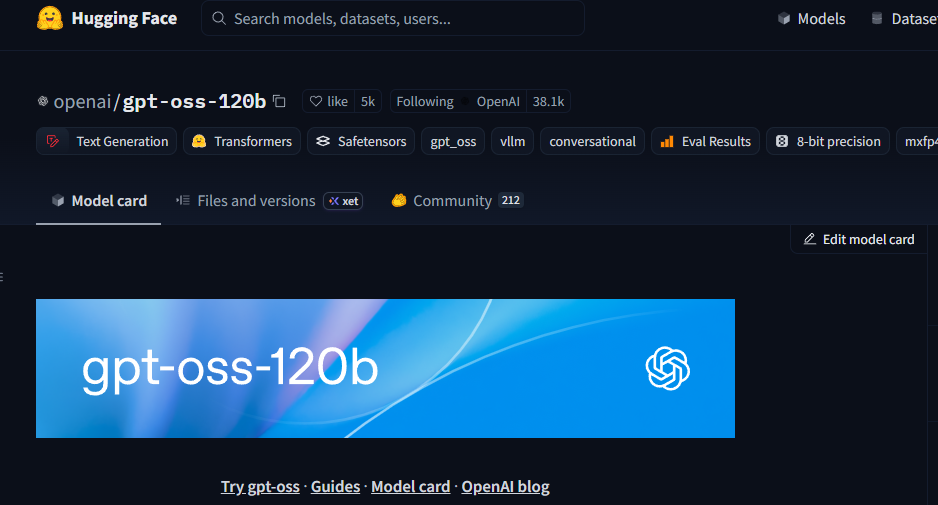
허깅페이스에 올라온 GPT OSS(오픈소스 소프트웨어)를 예로 들면 20B, 120B 같은 표기를 볼 수 있는데, 이건 모델의 크기다.
여기서 모델이 뭔지부터 짤막하게 설명하면:
📌 모델 = 아키텍쳐 + 가중치
- 아키텍쳐 → 쉽게 일종의 OS나 펌웨어라고 생각하면 된다
- 가중치 → 쉽게 확률 배열이라고 생각하면 된다
그러니까 GPT OSS 120B로 얘기를 하자면, 허깅페이스에 그 모델을 구성하는 아키텍쳐와 120B에 해당하는 가중치(확률 배열)가 공개되어 있는 것이다.
이렇게 가중치 자체를 공개해서 누구나 쓸 수 있게 하는 것을 오픈 웨이츠라고 한다.
(모델 공개랍시고 아키텍쳐만 공개하고 가중치는 안 올리는 것도 많음 🙄)
자, 무슨 말인지 이해 안 되면 몰라도 된다. 말하고 싶은 건 딱 하나다.
🔢 120B = 한국어로 1,200억 이라는 숫자다!!
LLM이 있으면 반대로 SLM (Small Language Model) 도 있는데, 보통 40B까지는 SLM으로 치는 것 같다.
GPT OSS 120B가 대충 GPT o3-mini/o4-mini 정도의 수준이라고 했으니, 사람이 쓰면서 '쓸만하다'라고 느끼려면 이 정도 모델 크기는 되어야 한다. 당연히 모델이 클수록 VRAM도 높아야 하고, VRAM이 받쳐주더라도 모델이 클수록 로딩과 답변에 시간이 매우 걸린다.
그래서 한때 맥 미니 혹은 맥 스튜디오를 8 클러스터 구축해서 GPT OSS 120B를 돌리는 영상도 있었다. (지금은 M4 코어 4개 클러스터 하면 쓸만한 수준)
⚡ 양자화(Quantization) — 가정집에서도 돌리자!
근데 이걸 기본적으로 가정집에서 돌리기에는 매우 벅차기 때문에 흔히 양자화 (양자컴퓨터 아님 😂) 라는 과정을 거친다.
💬 양자화란? 같은 모델 크기(B 단위)를 구동하더라도 사이즈는 작게, 속도는 빠르게 하는 기법이다. 물론 양자화 과정에서 필연적으로 성능 저하는 발생하지만, 이걸 개선시키기 위한 방법들도 많이 존재한다.
서버맨도 허깅페이스에 올라온 웬만한 모델들을 예전부터 한두 개쯤 돌려봤지만... "에이~ 이거 집에선 도저히 할 수가 없네." 했다가 최근에 GEMMA4:E4B 출시부터 무릎 탁 치고 진짜 Local LLM의 재미에 빠져들기 시작했다 🎯
🖥️ GPU 이야기 — 왜 GPU인가?
AI 연구 자체는 훨씬 오래됐지만, 실용화의 폭발적 계기는 GPGPU였다.
또, GPGPU 라는 것도 예전부터 있었지만 2012년 AlexNet(이미지넷 대회)이 GTX 580 두장을 병렬로 학습한 CNN이 압도적 우승하면서 많이 딥러닝의 진가가 알려지기 시작했다.
그 후, 일반 사람들이 그 실제 가치를 처음으로 알아보기 시작한 건 역시 '알파고(2016)'의 등장이었다.
그러다 그러려니... 세계 최강 이세돌 기사가 졌구나 하고 넘어갔겠지만, 두 번째로 세상 사람들의 관심을 끌게 된 건 역시 'ChatGPT(2022.11)' 웹서비스의 등장이다.
이전에도 대화하는 챗봇 정도야 어느 정도 있었지만, ChatGPT의 첫 등장 때는 컬처쇼크 그 자체였다. 답변의 퀄리티도 상당했고 속도도 어마어마했고 그냥 신세계였다 🌍
그러다 이제는 각종 전문 분야의 모델들이 나와서:
- 🎵 음악 만들어 주는 SUNO 모델
- 🎬 비디오 만들어주는 Hailuoai(힉스피그), Vidu(씨댄스) 모델
- 🎨 그림 그려주는 Midjourney
- 💻 알아서 코딩해주는 각종 Agent 등
이제는 우리 생활에 없어선 안 될 정도로 자리잡았지만,
위에서 말했듯 사용법은 너무 편하게도 단 한마디인 '~해줘' 로 끝난다. (블록체인과의 차이 ㅜㅜ)
🟢 NVIDIA DGX — 억 소리 나는 서버
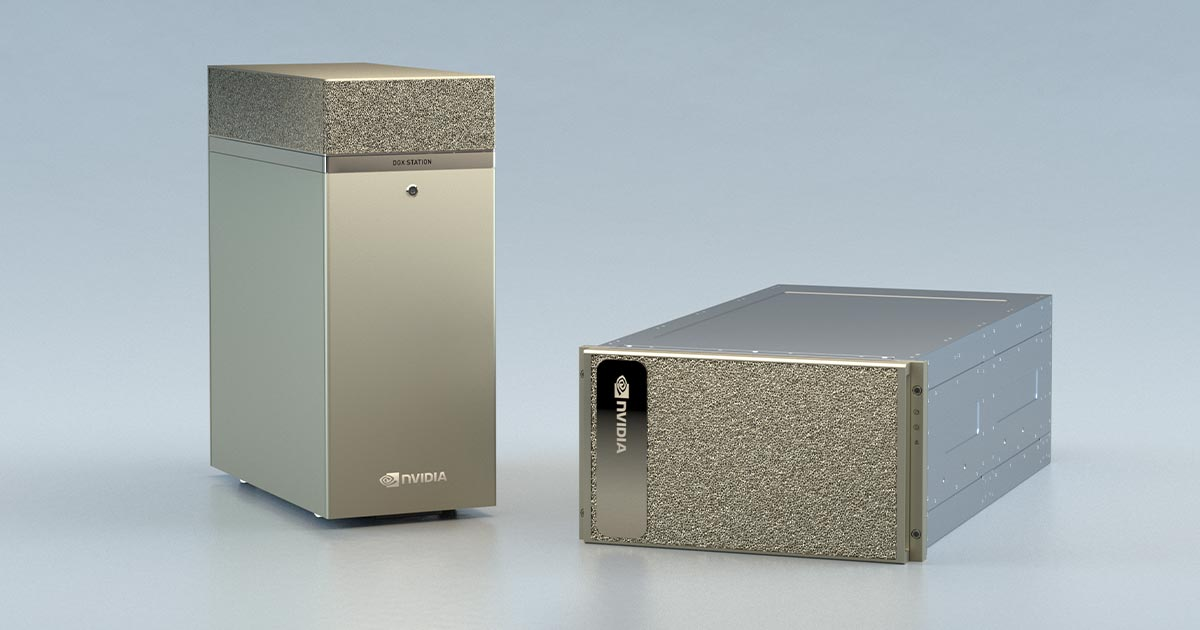
그런데 이런 대형 모델들은 일반적인 소비자용 그래픽카드로 돌리긴 쉽지 않다.
서버맨이 대학원 시절 서버실 담당도 겸하였는데, 서버실에 가면 대부분 RACK 형태의 서버가 가득하지만...
선반 하나를 멋지게 혼자(?) 차지한 NVIDIA DGX 황금 골드런(?) 같은 타워형 러닝 서버가 있었다!
당시 학교에서 대대적으로 AI 가속기를 구입 중이었고, 21년 기준 약 3억원어치를 구입 중에 8층(서버맨의 연구실이 있던 곳)에 한 대 들어온 게 아마 당시 가격으로 A100짜리 4장 꽂혀있는 DGX 였으니까 대충 대당 3천만원 가량 했을 거로 기억한다. 😱
🔌 SXM / HGX 규격 — PCIe에 꽂히지 않는 GPU들
하나 알아가면 좋은 것이, A, H, B 계열의 AI 가속기 GPU들은 일반적인 데스크톱 메인보드의 PCIe 슬롯에 꽂히지 않는다.
그들은 AI 서버 보드와 사실상 일체형 비슷하게 나오는 SXM, HGX 라는 규격을 사용한다.
🖥️ DGX Station는 NVIDIA에서 엔비디아 전용 OS(우분투 기반)까지 설치해서 완본체 형식으로 판매하는 타워형 서버다.
🟩 CUDA — 엔비디아 주가의 진짜 이유
엔비디아의 주가가 요새는 조금 출렁하지만 지난 10년간 거의 슈퍼 우상승이었으며, 지금도 명실상부한 시가총액 1위인 이유 중 하나는 바로 CUDA 이다.
간단하게 말하자면:
| 학습 | 가중치와 하이퍼파라미터 값을 변화시키면서 최적의 값을 찾는 파인튜닝 |
| 추론 | AI(LLM)가 결과를 내는 것, 즉 대답을 하는 것 |
NVIDIA는 2006년부터 CUDA 기반의 생태계를 확립하는 데 노력해왔고, 대부분의 AI 및 딥러닝 라이브러리들(PyTorch, TensorFlow, Keras...)이 기본적으로 CUDA 기반으로 오랫동안 개발되어 왔기 때문에 AMD 그래픽카드의 ROCm 기반으로 번역이 된다 한들 완벽하지 못하거나 성능 저하가 발생한다.
물론 최근의 Ollama, LM Studio, Jan 같은 LLM 추론 프레임워크들이 AMD 그래픽카드(MI 가속기나 RX류)를 잘 지원해주지만, 여전히 학습에 있어서는 CUDA가 안정적이라고 볼 수 있다.
🇰🇷 젠슨황의 한국 방문 — GPU 26만장 깜짝 선물!
젠슨황이 한국에 2025년 10월 APEC 정상회의 때 방문해서 깜짝 발표로 한국에 독점적 GPU 26만장 공급한다고 했는데, 이게 어느 정도 규모냐면:
| 🇺🇸 구글 (Alphabet) | 약 100만 ~ 150만 장 |
| 🇺🇸 마이크로소프트 | 약 75만 ~ 90만 장 |
| 🇺🇸 메타 (Meta) | 약 55만 ~ 65만 장 |
| 🇺🇸 아마존 (AWS) | 약 25만 ~ 40만 장 |
| 🇰🇷 대한민국 (26만장 추가 후) | 총 30만 장 이상 |
(배분: 공공 5만장 + 삼성 5만장 + SK 5만장 + 현대차 5만장 + 네이버 6만장)
🏆 26만장 공급이 완료되면 자연스럽게 AI 강국 순위가 미국 → 중국 → 그 다음 한국으로 자연스럽게 자리잡을 수 있다!
🔧 탈(脫) CUDA를 위한 노력들
물론 NVIDIA, AMD 말고도:
- 메타(Meta) → 자체 AI 칩 MTIA (RISC-V 기반 ASIC, 추천 알고리즘과 LLaMA 학습·추론에 최적화)
- 구글(Google) → TPU (Tensor Processing Unit)
- 아마존(AWS) → Trainium
- 마이크로소프트 → MAIA
를 내세우면서 학습과 추론 모두 가능하게 연구/개발 중이며, CUDA의 독점적인 생태계를 벗어나려는 노력을 계속하고 있다.
🌐 소버린 AI — 왜 지금 이게 중요한가?
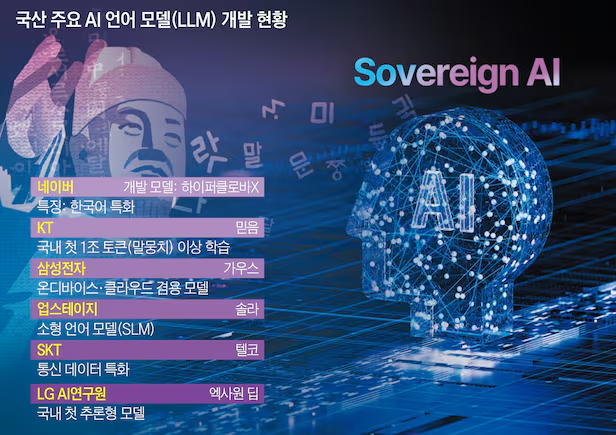
Sovereign(소버린)이란 영어로 '주권(主權)' 을 뜻한다. 즉 소버린 AI = 주권 인공지능 으로, 특정 국가나 조직이 외부 기술에 의존하지 않고 자국 내의 인프라, 데이터, 인력, 기술력을 활용하여 독자적인 AI 생태계를 구축하고 운영하는 능력을 의미한다.
(원래 단어자체는 소버린 블록체인이 더 먼저 나왔음 😤)
그런데 말이다...
😱 지금 한창 쓰고 있는 ChatGPT, Claude, Gemini가 갑자기 한국 서비스를 중단한다면?!
💸 AI라는 강력한 무기를 빌미로 구독제 가격을 터무니없이 높여버린다면?!
'어 안 쓰면 그만이야~' 가 아니다. 이제는 안 쓰면 죽는 세상이다. 📵
그래서 국내에서 국가대표 AI, 일명 독자 AI 프로젝트 를 추진했고, 사건사고가 많았지만 아직 진행 중이다. 좀 더 지켜보자.
💻 그럼 국가마저 막으면? → Local LLM!
근데 만약에 대한민국 마저도 내가 AI 쓰는 걸 막아버린다면?
하지만 그 경우엔 우리가 VPN을 쓰듯이(?) 로컬 LLM을 돌리면 된다.
✅ 당연히 성능은 덜하겠지만 안 쓰는 것보단 훨 낫다.
(근데 돈 많은 개인은 아까말한 클러스터 구축해서 GPT OSS 120B 같은 모델 쓰면 됨 😄)
그리고 PART 3에서 다루겠지만, 자신의 LLM이 있으면 활용할 방도는 굉장히 많이 있다! 🛠️
✍️ 마무리
이번 포스팅에서는 AI, LLM, GPU, 소버린 AI에 대한 기본 개념들을 간략하게 훑어봤다.
사실 각 주제 하나하나가 논문 한 편 분량일 정도로 깊은 내용들이지만, 서버맨 스타일로 최대한 쉽게 정리해봤다.
다음 포스팅인 PART 2에서는 실전으로 들어가서, 본격적으로 Ollama 구축 및 환경 설정을 다룰 예정이다.
그때부터가 진짜 재밌는 부분이니까, 기대해도 좋다 😎
📌 PART 2에서는 Ollama 설치부터 모델 세팅까지 직접 해보자!
질문은 언제나 환영 🙌
🛰️ 서버맨의 공간들
'Local AI > Ollama' 카테고리의 다른 글
| [AI] 🤖 AI와 GPU 그리고 Local LLM (소버린 AI) PART 3 (0) | 2026.09.02 |
|---|---|
| [AI] AI와 GPU 그리고 Local LLM (소버린 AI) PART 2 (0) | 2026.08.10 |

