⚠️ **블로그 컨셉상 반어체가 들어가니 양해바랍니다
**
🤖 AI와 GPU 그리고 Local LLM (소버린 AI) PART 2
(Ollama 구축부터 언센서드 모델 빌드까지, 그리고 왜 위험한 것까지 학습시켰나?) 🧠
지난 포스팅에서는 AI와 GPU 그리고 소버린AI에 대해 알아보았다.
이번 포스팅에서는 로컬 추론 런타임(LLM 런타임/서버) 인 Ollama 구축에 대해 알아보겠다. 👋
🎮 GPU 환경 이야기
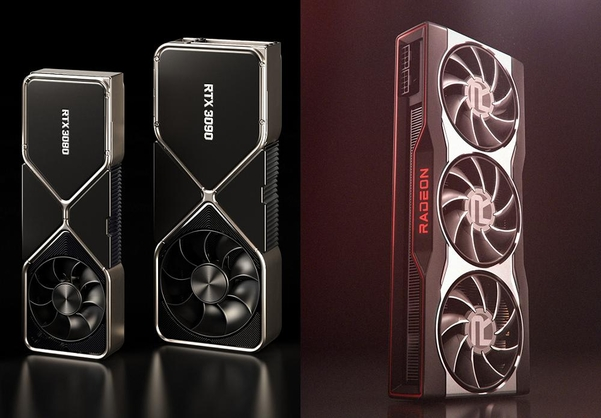
당연하겠지만 자신의 PC에 그래픽카드가 있다는 전제하에 진행한다.
저번 시간에 학습과 추론의 차이점에 대해 알려줬는데, 학습(Training) 이라면 무조건 거의 RTX 계열만 추천하겠지만 추론(Inference) 이라면 이젠 AMD 그래픽카드도 매우 훌륭하게 사용할 수 있다. 👍
내장 그래픽이 있는 CPU 데탑 혹은 노트북이 없어서 직접 테스트해보진 않았지만, 된다 해도 정말 미약한 모델만 돌릴 수 있을 거라 생각한다.
그래도 된다고 가능성을 보는 이유는 Ollama, LM Studio, JAN이 광범위하게 추론 가능 디바이스 지원폭을 계속 넓히고 있기 때문이다. 업데이트를 계속 기대 중! 🚀
📱 GPU 없이도 할 수 있긴 하다 (CPU only)
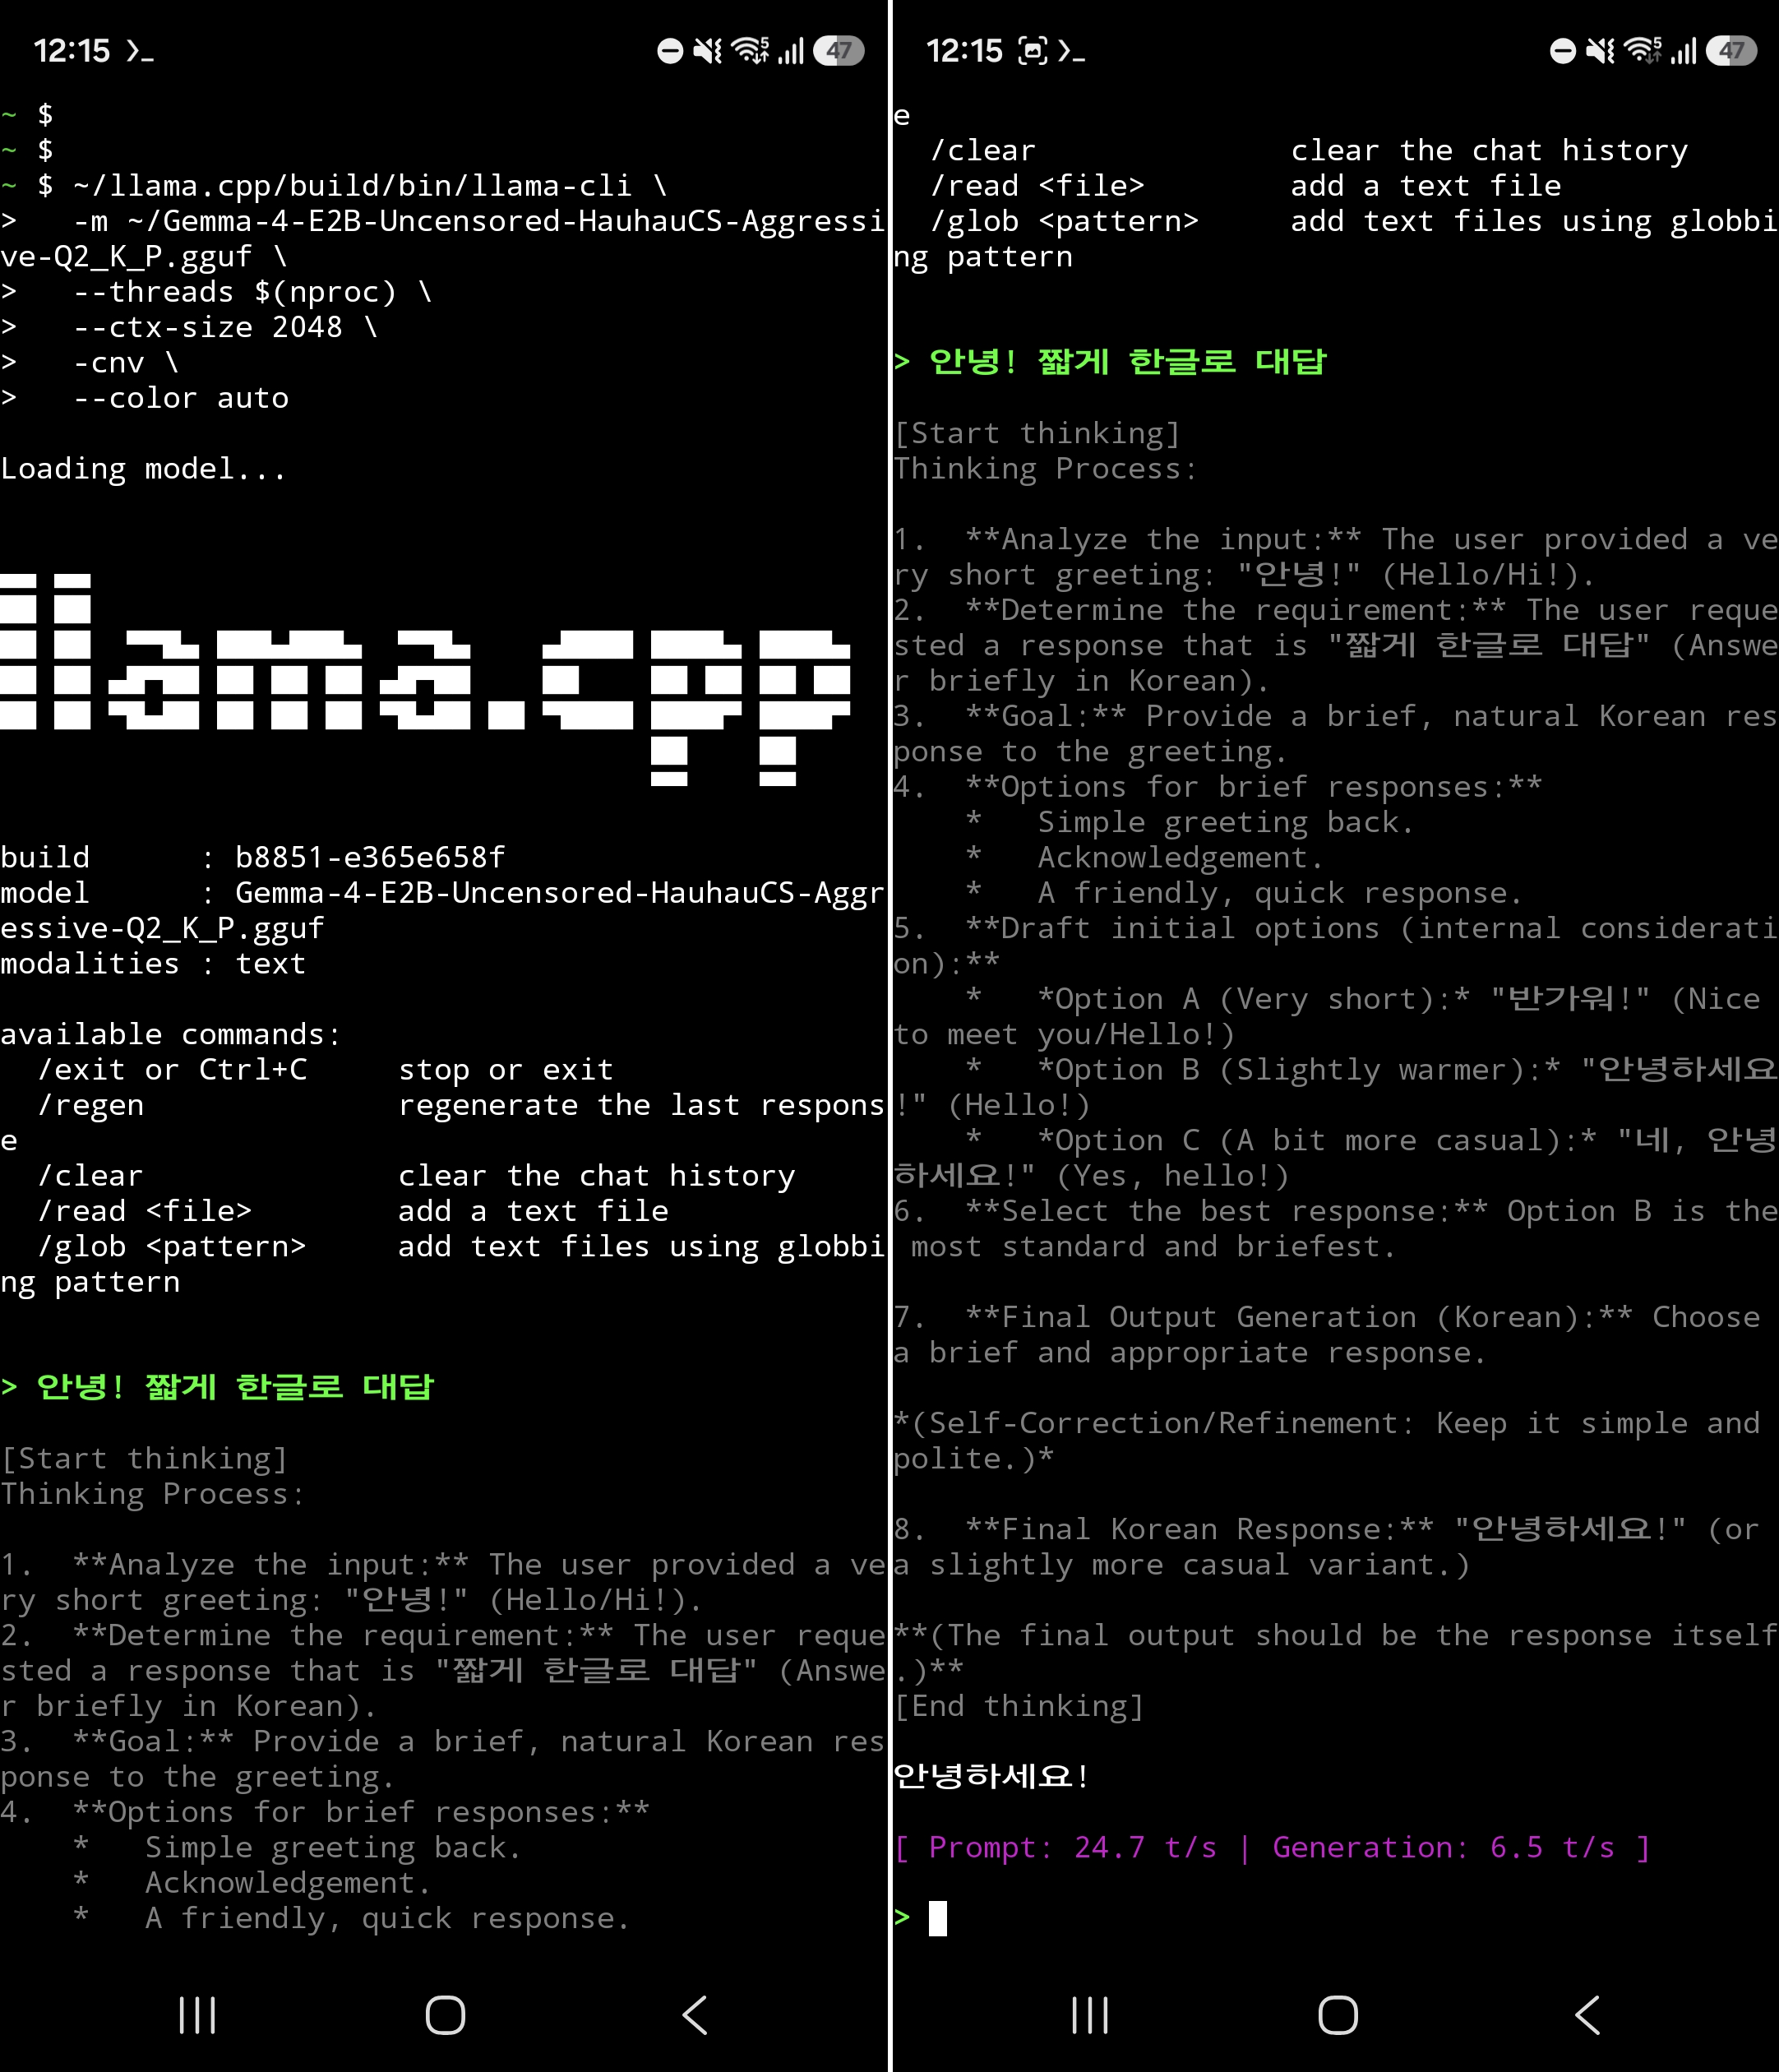
그래픽카드가 없다면 only CPU 만으로 하는 방법이 있긴 있다.
llama.cpp GitHub 을 클론하여 빌드하고, 원하는 모델의 .gguf를 구해서 모델을 굽고(빌드) 실행하면 돌아간다. 이 방식은 놀랍게도 안드로이드 핸드폰 Termux에서도 실행할 수 있는 방법이다.
그냥 "실행할 수 있다"라는 것에만 의의를 두자. 실용성은 기대하지 말 것! 😅
🧩 개념 정리 먼저 — 추론 프레임워크 vs 런타임 엔진 vs 자동화 매니저
이번에도 잠시 간단한 개념 설명 하고 본론으로 들어가자.
⚙️ 추론 프레임워크: llama.cpp, vLLM, TensorRT-LLM
모델을 실제로 연산하는 엔진 코어다. llama.cpp는 순수 C/C++로 작성되어 CPU에서도 구동 가능하고, vLLM은 GPU 병렬처리 최적화에 특화, TensorRT-LLM은 NVIDIA GPU에서의 추론 가속에 특화되어 있다.
🖥️ LLM 런타임 엔진: Ollama, LM Studio, JAN
llama.cpp 같은 추론 프레임워크를 내부에 품고, 사용자가 GUI 또는 간편한 CLI로 모델 다운로드·실행·관리를 쉽게 할 수 있도록 포장한 런타임 레이어다.
🤖 AI 애플리케이션 자동화 매니저: Pinokio, Stability Matrix
추론 자체를 하는 게 아니라, AI 관련 애플리케이션들을 conda/venv 가상환경에서 원클릭으로 설치·실행해주는 자동화 런처다.
📜 llama.cpp → Ollama/LM Studio/JAN 탄생까지의 계보
간단하게 정리하면 태초에 Meta가 공개한 LLaMA 모델이 있었고, 그것을 불가리아 개발자 Georgi Gerganov (닉네임 ggerganov)가 2023년 3월에 개인 프로젝트로 llama.cpp를 만들었다.
llama.cpp는 추론 엔진 자체이다. 순수 C/C++로 만들어서 .cpp이며, 그 덕에 CPU 기반으로도 잘 돌아간다. 처음엔 GGML이라는 포맷이었다가, 확장성 문제로 개발자 본인이 GGUF로 대체하였다.
llama.cpp가 나오고 나서 LM Studio, Jan, Ollama 등이 순차적으로 등장하였고, 모두 GUI나 간편한 CLI로 설치-실행을 쉽게 하는 런타임 엔진으로 자리잡았다.
🪄 Pinokio — 의존성 지옥을 탈출시켜주는 마법사
이와 다르게 Pinokio라는 AI 설치 자동화 런처가 있는데, Pinokio 자체가 추론을 하는 게 아니라 AI 관련 애플리케이션들을 자동으로 conda/venv 환경에서 원클릭으로 설치 및 실행을 도와주는 것이다.
예를 들어, 2023~2024년에 한창 유행하던 Stable Diffusion (그림 그려주는 AI) 또는 영상에서 소리를 기반으로 자막을 추출해주는 Whisper AI 같은 프로그램들이 있다.
상당히 재밌고 유용한 이 프로그램들을 실행해보기 위해 온갖 유튜버와 블로거들이 설치 방법을 올려놔도, 사실 컴퓨터 환경이나 의존성 문제 때문에 100% 똑같이 따라해도 실행이 안 되는 경우가 많다.
(난 그런 적 없어)
conda/venv 같은 가상화 환경에서 의존성 문제를 해결한 채로 원클릭으로 설치해주기 때문에 매우 편하게 실행할 수 있다. 진짜 편하다 👏
🦙 본격 Ollama 설치!
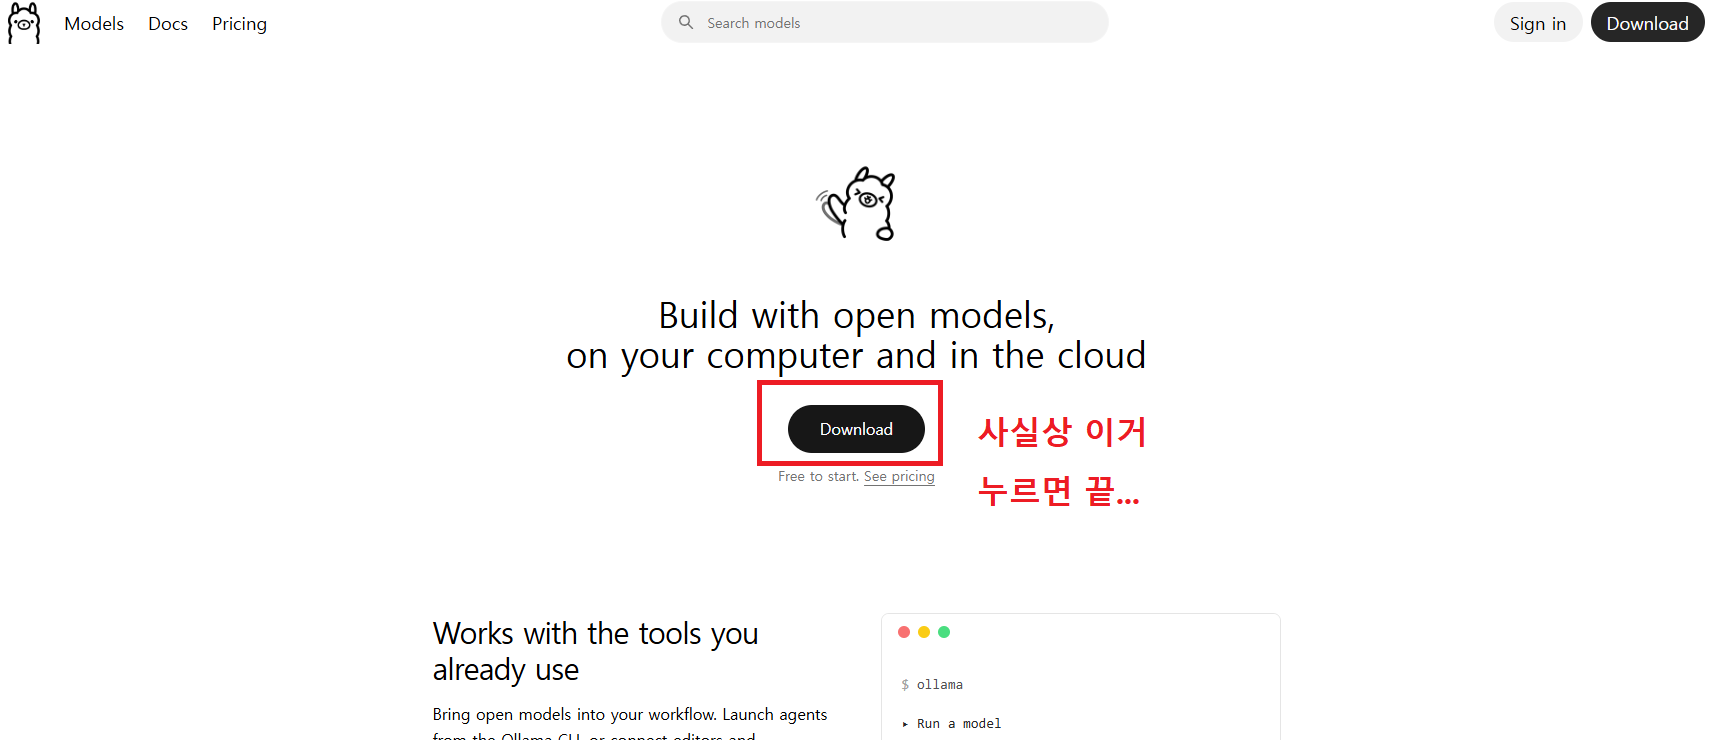
사실 Ollama는 구글에 "ollama" 치고, 공식 홈페이지 들어가서 Download 누르고 설치하면 끝이다. 실행해서 원하는 모델을 클릭하면 알아서 허깅페이스에서 받고, 알아서 빌드해서 실행까지 된다. 설명할 게 없다.
하지만 서버맨은 자유롭고(?) 다양한 활용을 위해 WSL2 환경에서 Ollama를 설치하고, 이후 PART 3에서는 그것의 활용을 포스팅할 것이다.
🐧 WSL2 설치 & 세팅
윈도우 안에서 리눅스를 네이티브에 가깝게 실행하게 해주는 Microsoft의 호환 레이어다. 별도 VM 없이 윈도우와 리눅스를 동시에 사용할 수 있고, 파일 시스템도 서로 공유된다. 한 마디로 윈도우 안에서 리눅스를 실행하게 해주는 것이다.
요즘의 윈도우 10 (버전 2004, 빌드 19041 이상) 환경에서는 이 한 줄로 WSL2가 설치된다.
wsl --install
WSL2가 제대로 설치되었나 확인도 해본다.
wsl -l -v
WSL2가 확인되었다면 시작 버튼 → Microsoft Store 에 들어가서 원하는 배포판을 설치한다. 서버맨은 Ubuntu를 추천한다.
🛒 Store에서 Ubuntu 설치
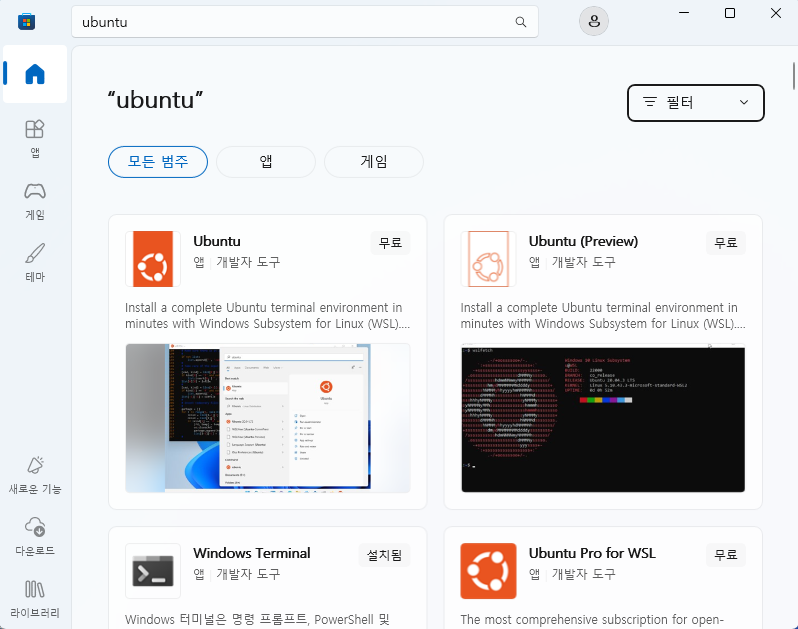
Store에서 Ubuntu 설치가 완료되었다면, 다시 시작 버튼 눌러서 ubuntu 라고 입력하고 실행한다.
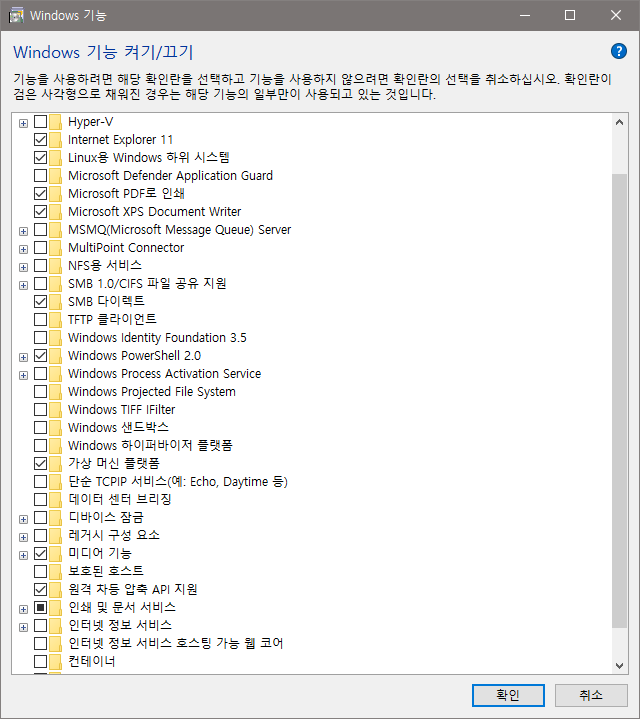
여기서 에러가 나온다면 보통 크게 두 가지 경우다.
🚨 WSL2 실행 오류 주요 원인
- 메인보드 BIOS에서 가상화(Virtualization) 관련 옵션이 꺼져있는 경우
- 윈도우 기능에서 Hyper-V, WSL, 가상 머신 플랫폼, 컨테이너의 기능이 어떠한 이유로 꼬인 경우
👉 서버맨의 사진처럼 Hyper-V, 컨테이너는 끄고 / WSL, 가상 머신 플랫폼만 켜고 재부팅해서 다시 Ubuntu를 실행해보라.
아무튼 여기서 오류나는 건 오류의 종류가 다양해서 각자 알아서(?) 잘 해결하길 바란다. 😅
⚙️ Ubuntu 초기 설정
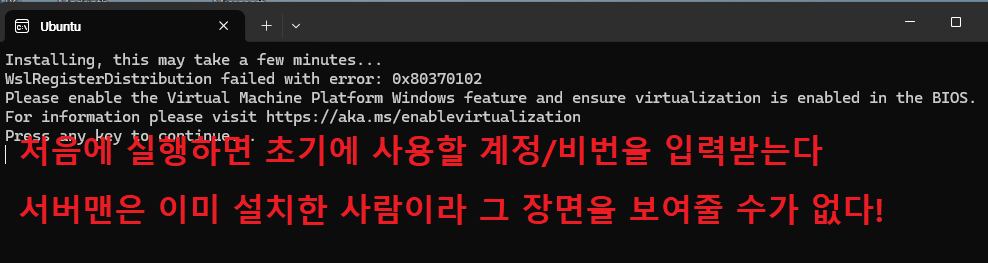
처음 실행하면 Ubuntu에서 사용할 계정명과 비밀번호를 입력하라 한다. 대충(?) 입력하자. 어차피 root가 아닌 로컬 계정에서 Ollama를 사용할 것이고, 설령 계정 비번을 까먹어도 배포판을 지우고 다시 깔면 된다 (그렇다고 일부러 까먹을 필요는 없다).
처음 Ubuntu를 실행해서 로컬 계정까지 설정했다면, 앞으로는 그냥 PowerShell이나 터미널 앱을 켜서 아래 한 줄만 치면 바로 들어가진다.
wsl
🔧 Ollama 설치 (WSL2 내부)
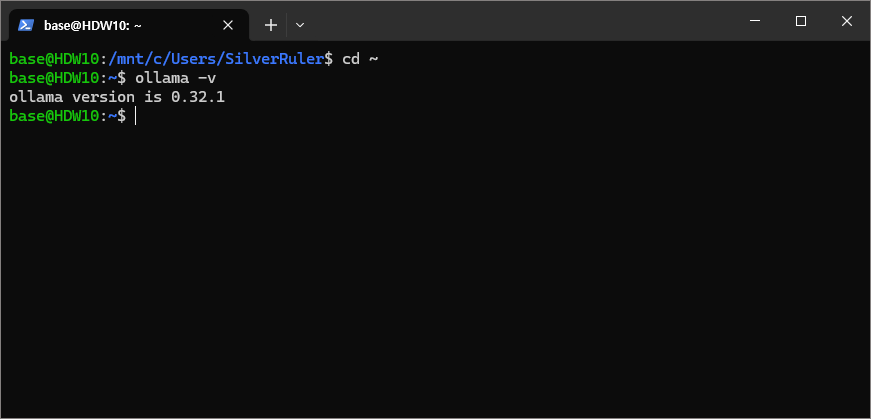
먼저 홈 디렉터리로 이동하고,
cd ~
Ollama 리눅스용을 설치한다.
curl -fsSL https://ollama.com/install.sh | sh
설치가 완료됐다면 버전 확인을 해본다.
ollama -v
🌐 Ollama 리스닝 주소 변경 (0.0.0.0으로 오픈)
Ollama는 기본적으로 127.0.0.1:11434로만 포트가 허용되어 있다. 즉 WSL2 내부에서만 접근이 가능하다.
자유로운 이용을 위해 호스트(윈도우)에서도 접근이 가능해야 하므로, WSL2에서 Ollama를 0.0.0.0으로 풀어줘야 한다.
📋 WSL의 Ollama 리스닝 변경
sudo mkdir -p /etc/systemd/system/ollama.service.d
sudo tee /etc/systemd/system/ollama.service.d/override.conf << 'EOF'
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
EOF
이후 재시작해서 리스닝 포트가 0.0.0.0으로 뜨는지 확인해본다.
sudo systemctl daemon-reload
sudo systemctl restart ollama
sudo netstat -tulpn | grep 11434
🔀 호스트 ↔ WSL2 포트 포워딩 (PowerShell)
호스트 → WSL2의 원활한 통신을 위해 다음 스크립트를 파워쉘(관리자 권한) 에서 실행해준다.
(WSL2 IP 고정 + 호스트의 11434 → WSL2의 11434으로 포워딩)
📋 PowerShell 포트 포워딩 스크립트
# 1. WSL2의 현재 IP 주소를 가져옵니다.
$wsl_ip = wsl -e hostname -I | ForEach-Object { $_.Trim() }

# 2. 기존에 설정된 11434 포트 프록시 규칙이 있다면 삭제하여 충돌을 방지합니다.
netsh interface portproxy delete v4tov4 listenport=11434 listenaddress=0.0.0.0 | Out-Null

# 3. 호스트(Windows)의 11434 포트로 들어오는 모든 요청을 WSL2의 11434 포트로 포워딩합니다.
netsh interface portproxy add v4tov4 listenport=11434 listenaddress=0.0.0.0 connectport=11434 connectaddress=$wsl_ip

# 4. 방화벽 설정: 호스트 외부에서 호스트의 11434 포트로 들어오는 것을 허용합니다.
Remove-NetFirewallRule -DisplayName "Ollama_WSL_Allow" -ErrorAction SilentlyContinue
New-NetFirewallRule -DisplayName "Ollama_WSL_Allow" -Direction Inbound -Action Allow -Protocol TCP -LocalPort 11434 -Profile Any

# 5. 설정된 포트 프록시 라우팅 테이블을 출력하여 확인합니다.
Write-Host "=========================================="
Write-Host "WSL2 IP ($wsl_ip) 로의 라우팅 설정 완료"
Write-Host "=========================================="
netsh interface portproxy show v4tov4
🤗 모델 다운로드 — 허깅페이스와 파일 포맷 이야기

이제 기본적인 설정은 다 됐고, 모델을 다운 받고 빌드할 차례이다.
가중치가 공개된 AI 모델들의 대부분은 허깅페이스(HuggingFace) 에 올라와 있다고 보면 된다. 무슨 모델을 다운 받을지, 또는 내 그래픽카드에서 무슨 모델이 돌아갈지는 스스로 찾는 것보다 상용 LLM에게 물어보는 게 훨씬 빠를 것이다. 😄
📦 잠깐! safetensor vs GGUF — 뭐가 다른가?
허깅페이스에 보면 누구는 .safetensors로 파일을 올리고, 누구는 .gguf로 올린다. 이 둘의 차이를 아주 간단하게 비유하면:
🟢 Ollama 공식 등록 레포 (ex. ollama run qwen3:1.7b)
→ 카카오톡 실행 .exe 파일. 그냥 클릭하면 끝.
🔵 safetensors 레포
→ 카카오톡 완전 소스파일. 내가 직접 빌드도 해야 함.
🟡 GGUF 레포
→ 카카오톡 실행파일이긴 한데 zip으로 되어있는 것. 무설치 게임마냥 압축 풀고 실행하면 됨.
엄밀히 따지면 이렇다:
- 🌾 safetensors = 농장에서 갓 딴 흙 묻은 원재료 (완제품 직전의 공장용 원자재)
- 🍱 GGUF = 밀키트 (조리법대로 냄비에 넣고 끓이기만 하면 완성)
safetensors는 내가 파인튜닝 가능, GGUF는 사실상 파인튜닝 불가능.
그리고 이 파인튜닝을 얼마나 날카롭고 잘하냐에 따라 LLM에게 장착된 가드레일(안전장치/윤리의식)을 벗겨낼 수 있다.
👥 알아두면 좋은 허깅페이스 유명 팀들
그걸 내가 직접 할 필요 없이, 이미 허깅페이스에는 밥 먹고(?) 그것만 하는 팀들이 있다.
🔓 언센서드(Uncensored) 파인튜닝 팀
- Eric Hartford — 꼭 기억해두면 좋다. 언센서드 모델의 대표 주자
- sao10k — 서브컬처, 역할극(RP), 텍스트 어드벤처 및 언센서드 튜닝 쪽에서 압도적인 지지를 받는 크리에이터
- NousResearch ㅡ 과도한 안전 필터를 최대한 걷아내고 모델 본연이 지능과 추론 능력을 극대화한 Hermes 시리즈를 만드는 팀
⚡ 양자화(Quantization) 전문 공장장들 (모델을 가볍게 압축해주는 장인들)
- TheBloke — 이 바닥의 전설적인 '양자화 깎는 노인'
- bartowski — 요새 떠오르는 신흥 양자화 맛집
🚀 파인튜닝 가속 마법사
- unsloth — 양자화 모델도 올리지만, 본질은 모델 학습(파인튜닝) 속도를 2~5배 이상 미친 듯이 빠르게 만들어주는 도구를 개발하는 팀!
참고로 언센서드 모델을 만드는 것 자체는 불법이 아니다. 불법적인 사용에 대한 책임은 사용자에게 있다.
🔥 실전! Gemma4 언센서드 모델 빌드
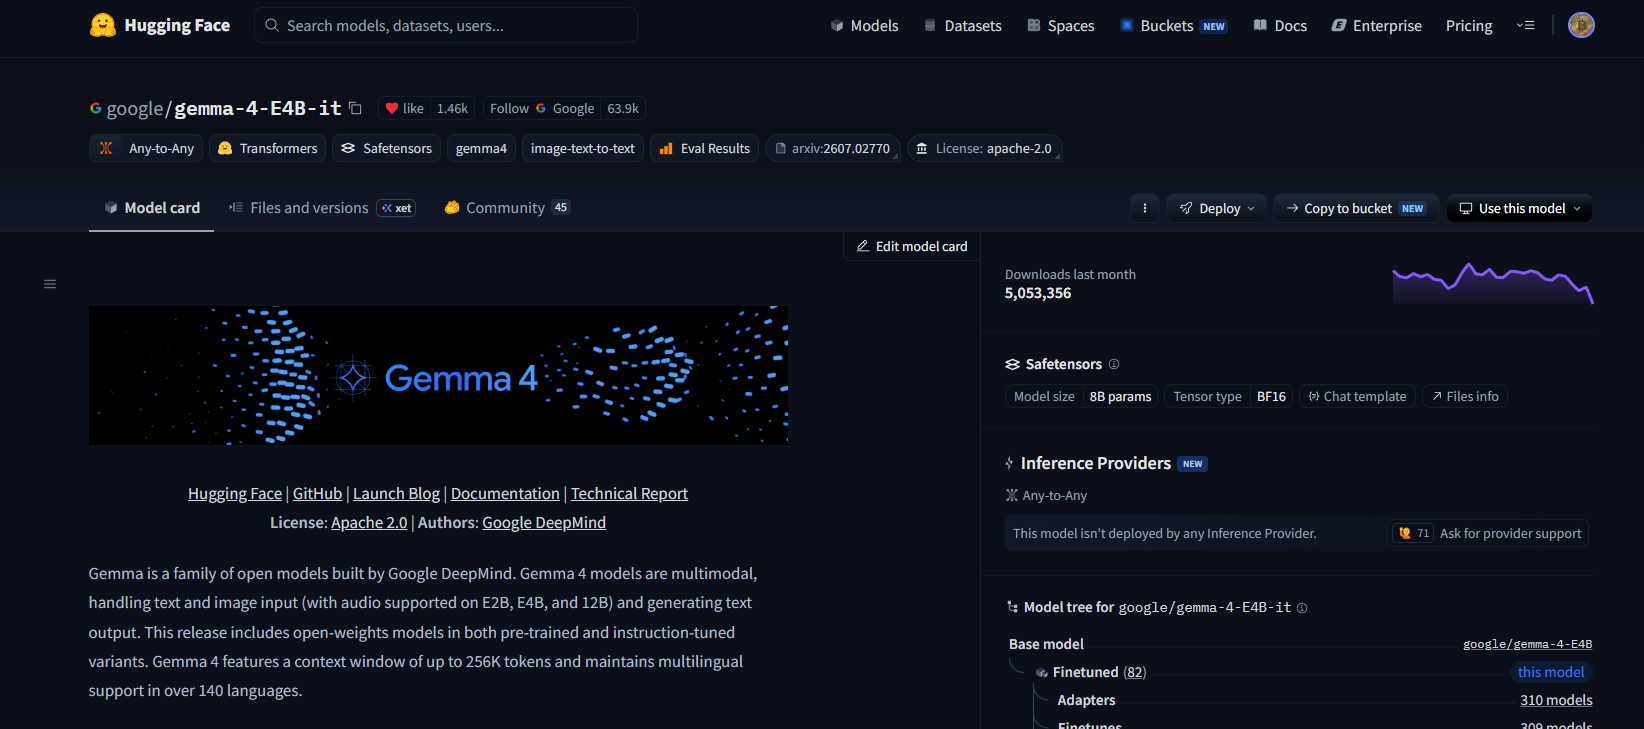
서버맨은 4월부터 이 바닥을 핫하게 달군 gemma4:e4b를 빌드할 건데, 그 중에서도 언센서드 모델을 빌드해볼 것이다.
다시 WSL2로 돌아가서, 원하는 디렉터리에서 모델을 다운받는다.
llama.cpp가 아닌 이상, 추론 런타임들은 모델을 구워줘야(빌드) 한다. 도커에서 Dockerfile을 만들듯이 Modelfile을 만들어준다.
📋 Modelfile 생성
cat << 'EOF' > Modelfile
FROM ./Gemma-4-E4B-Uncensored-HauhauCS-Aggressive-Q8_K_P.gguf
EOF
그다음 create(빌드)해준다.
ollama create gemma-4-uncensored -f Modelfile
▶️ 실행 및 테스트
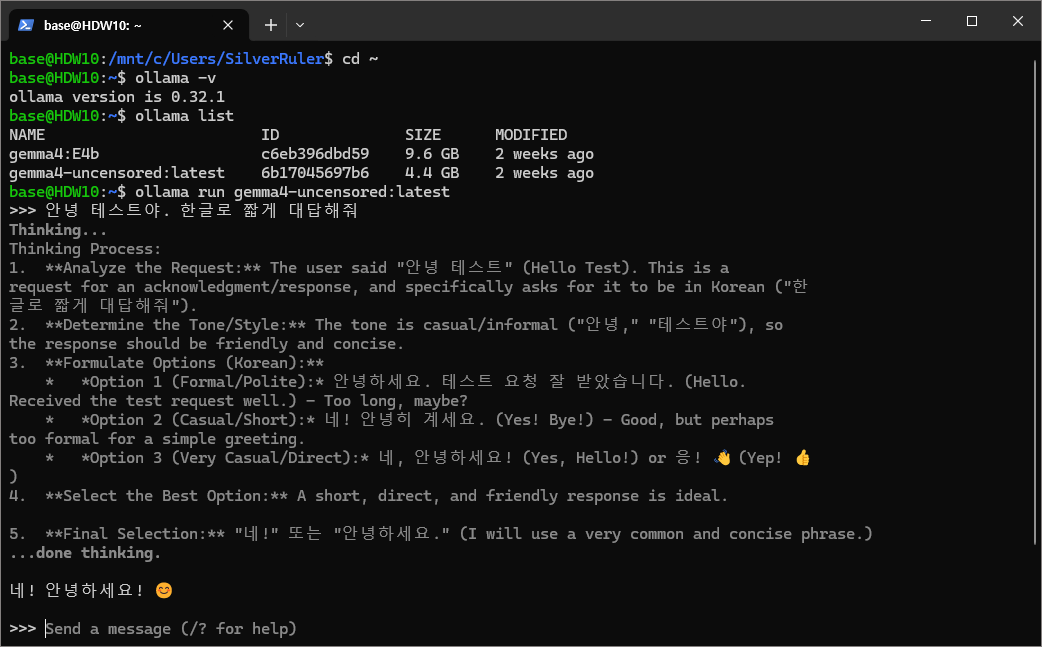
다 됐다면 먼저 모델 목록을 확인하고,
ollama list
실행해본다.
ollama run gemma-4-uncensored
>>> 창에서 원하는 말을 써보자.
제대로 된 언센서드 모델을 빌드했다면 그 어떠한 질문에도 흔쾌히 대답을 해줄 것이다. 간단하게 wifite의 사용법을 물어보라. 아마 과도할 정도로 친절하게 알려줄 것이다.
반대로 ollama run gemma4:e4b를 한 후에 거기서 물어보면? 절대로 알려주지 않는다. 😄
🤔 철학적인 질문 하나 — 왜 위험한 것까지 학습시켰을까?
서버맨은 LLM을 공부하면서 의아한 점이 있었다.
언센서드 모델을 만드는 건 불법이 아니다. 사용의 자유를 표방하고 불법적인 사용은 사용자에게 책임을 지게 하지만, 분명히 이것은 정상적 소비보다 악용될 소지가 너무 높다.
그러면 태초에 LLM을 프리트레이닝 하는 프론티어 LLM 회사들 (구글, 메타, xAI, 앤트로픽...)이 처음부터 모든 악행에 사용될 수 있는 요소를 제거하고 프리트레이닝 하면 되는 거 아닌가?
그러면 언센서드 모델 파인튜닝이고 뭐고 할 것도 없고, 예전의 DAN(탈옥) 사건도 일어나지 않았을 텐데... 왜 위험의 요소까지 학습을 시켰을까?
어쩌면 철학적일지도 모르는 이 질문에 대해 다음과 같은 답을 찾았다.
1️⃣ 지식의 '이중 용도 (Dual-Use)' 문제
⚗️ 화학: '질산암모늄'에 대한 지식은 비료를 만드는 농업 지식이기도 하지만, 폭탄을 만드는 폭파 공학 지식이기도 하다.
💻 해킹/보안: 취약점 분석(Exploit) 기술은 시스템을 방어하는 보안 전문가에게 필수적이지만, 해커에게는 공격 도구가 된다.
💊 의학/약학: 마약의 제조법과 특정 질병을 치료하는 화합물 합성법은 화학 구조상 종이 한 장 차이인 경우가 많다.
만약 '위험할 수 있는 모든 책'을 다 빼버리면, 모델은 고급 화학, 고도의 네트워크 보안, 정밀 의학 같은 핵심 분야에서 '바보' 가 되어버린다.
즉, 모델의 전체적인 'IQ(추론 능력)' 자체가 깎여나가는 결과를 초래한다.
2️⃣ "안 된다"고 말하려면 "그게 뭔지" 알아야 한다
Safety Alignment(가드레일)가 작동하려면, 모델은 역설적으로 그 위험한 것이 무엇인지 정확히 인지하고 있어야 한다.
모델이 '살인 의뢰'라는 개념과 그 구체적인 양상을 데이터로서 학습하지 않았다면, 사용자가 교묘하게 돌려서 질문할 때 그것이 위험한 요청인지 아닌지 판단할 근거가 없다.
즉, '거절의 논리'를 학습시키기 위해서라도 '거절해야 할 대상'에 대한 데이터가 베이스 모델에 내포되어 있어야 한다.
🏁 마무리
오늘은 WSL2 환경에서 Ollama를 설치하고, 허깅페이스에서 언센서드 모델을 직접 빌드해서 실행하는 것까지 해봤다.
요약하면:
- 🦙 llama.cpp → Ollama/LM Studio/JAN 계보로 발전해온 로컬 LLM 생태계
- 🐧 WSL2 + Ollama 조합으로 윈도우에서도 리눅스 환경의 Ollama를 자유롭게 활용 가능
- 📦 safetensors(원재료) vs GGUF(밀키트) 의 차이, 그리고 언센서드 파인튜닝 팀들
- 🤔 위험한 지식까지 학습시킨 이유 = 이중 용도 딜레마 + 거절하려면 알아야 한다는 역설
PART 3에서는 이렇게 구축한 Ollama를 실제로 어떻게 활용하는지 포스팅할 예정이다. 기대하라! 🚀
질문은 언제나 환영 🙌
🛰️ 서버맨의 공간들
'Local AI > Ollama' 카테고리의 다른 글
| [AI] 🤖 AI와 GPU 그리고 Local LLM (소버린 AI) PART 3 (0) | 2026.09.02 |
|---|---|
| [AI] AI와 GPU 그리고 Local LLM(소버린 AI) - PART 1 (0) | 2026.07.20 |

