⚠️ **블로그 컨셉상 반어체가 들어가니 양해바랍니다
**
🚀 무제한으로 굴리는 나만의 로컬 LLM
지난 PART 2에서 언센서드 Gemma 4 구동까지 직접 해보았다.
오늘은 이렇게 내 컴퓨터에 구축해 둔 로컬 LLM을 실전에서 알차게 활용할 3가지 핵심 방법에 대해 본격적으로 알아보겠다. 🚀
⚡ 활용법 1. 로컬 LLM API 직접 호출 (무제한 자동화 파이프라인)
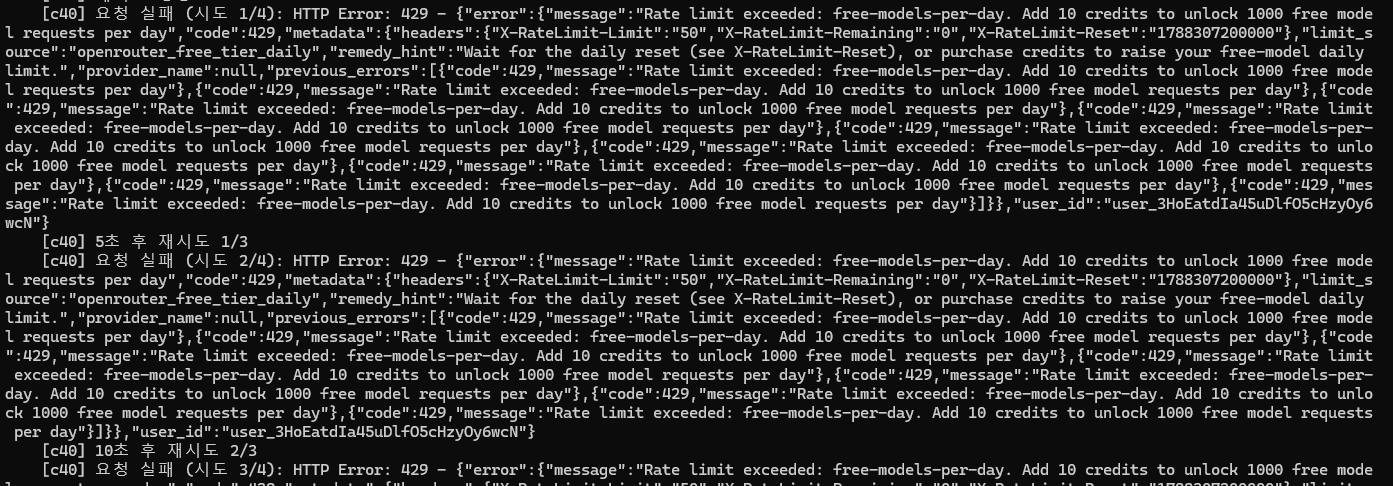
첫 번째로 활용할 방법은 바로 로컬 LLM API 직접 호출이다.
2026년에 누구나 한 번쯤은 상용 AI 서비스를 사용하면서 Quota Limit Exceed (사용량 한도 초과) 경고창을 겪어봤을 것이다. 😱
하지만 로컬 LLM을 사용하면 내 GPU가 고장 나지 않고 전기가 끊기지 않는 이상 한도는 무제한이다. ⚡
이를 활용하면 일상과 업무에서 마주치는 굉장히 많은 반복 작업들을 완벽하게 자동화시킬 수 있다.
🟢 로컬 LLM API로 가능한 업무 자동화 11가지

일단 간단한 예시를 나열해 보면 다음과 같다:
| 구분 / 업무 | 처리 파이프라인 | 결과물 / 처리 예시 |
|---|---|---|
| 📄 PDF 번역기 | 영문 PDF → OCR(필요시) → LLM 번역 | 원본 레이아웃 유지 → 한글 PDF |
| 🐙 GitHub 문서 번역 | README.md → LLM |
README_ko.md 생성 |
| 💻 코드 주석 번역 | 영문 코드 주석 → LLM | // Initialize network socket → // 네트워크 소켓을 초기화한다. |
| 📝 Git 커밋 메시지 | git diff → LLM |
feat: add websocket reconnect logic |
| 🔍 PR 코드 리뷰 | git diff → LLM |
변수명 모호성, 예외 처리 누락, Race condition 가능성 검토 |
| 📊 서버 로그 분석 | 100MB 대용량 서버 로그 → LLM | 에러 발생 원인 추적, 빈도 분석, 해결책 제시 |
| 🎙️ 회의록 요약 | Whisper → 텍스트 추출 → LLM | 핵심 요약, TODO 리스트, Action Item 도출 |
| 📧 대량 이메일 정리 | 수백 개의 수신 메일 → LLM | 중요 메일, 광고, 답장 필요 메일 자동 분류 |
| 🖼️ OCR + 이미지 번역 | 이미지 파일 → OCR → LLM | 이미지 내 텍스트 한국어 번역 |
| 🎬 유튜브 자막 번역 | yt-dlp → Whisper → SRT → LLM |
자연스러운 한글 자막 SRT 생성 |
| 🌐 웹사이트 현지화 | HTML 소스코드 → LLM | 태그 보존 한국어 HTML 변환 |
🟣 번역/요약과 도구 호출(MCP)의 차이점
일단 이 정도까지만 나열해 봤을 때 상당수가 번역과 관련된 작업이다.
그 이유는 일단 Whisper나 OCR 같은 경우는 모델 파라미터(B수)가 높고 성능이 좋으며 자체 기능이 많이 탑재되어 있으면 알아서 할 수도 있겠지만,
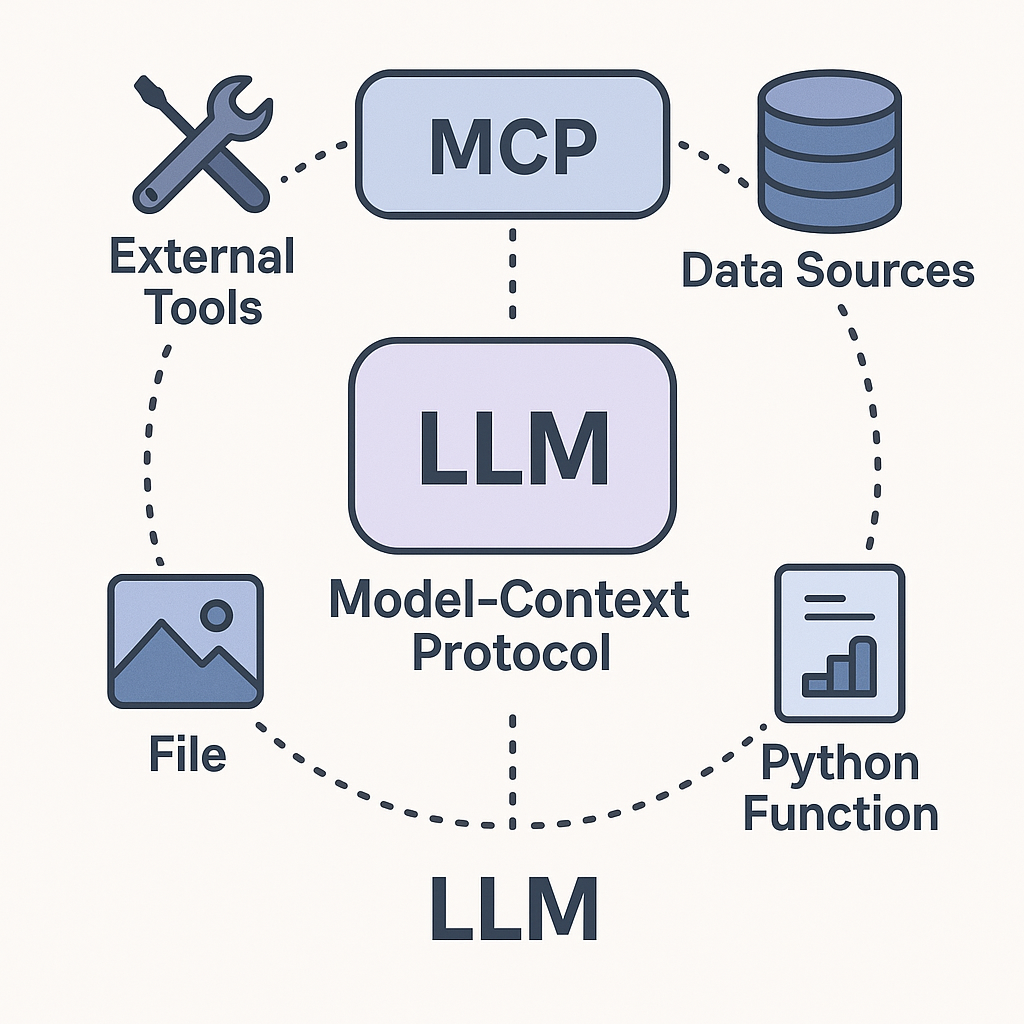
그렇지 못할 경우에는 Skills, Plugins, MCP (Model Context Protocol) 같은 'AI가 외부 도구를 직접 호출하는 행위'를 스스로 할 수 있게 환경을 세팅해야 한다.
🟤 번역 퀄리티 : 구글 번역기 vs LLM 언어 생성
*"번역 그까이꺼 대충 그냥 구글 번역기 돌리면 되는 거 아님?"* 🤔
LLM이 수행하는 번역과 단순한 구글 번역기가 하는 번역의 퀄리티 차이는 상상을 초월한다!
물론 구글 번역기도 오래전부터 신경망 기계번역(NMT)을 사용하고 있지만, LLM이 하는 번역은 사실상 단순 1:1 매핑 번역이 아니라 새로운 언어 생성에 가깝다.
1. 이전 문맥에 따라 앞뒤의 전체 맥락을 파악하고 번역한다.
2. 방대한 텍스트 데이터를 바탕으로 "이 상황에서 가장 자연스러운 표현이 무엇인가"를 추론한다.
3. 단순 사전적 의미를 넘어 관용어, 뉘앙스, 비꼬는 표현까지 완벽하게 이해하고 번역해 낸다.
🟠 서버맨의 실전 자동화 파이프라인 사례

일단 서버맨도 매일 12:30에 크론(Cron) 스케줄러를 돌리고 있는 실전 작업이 있다.
daycare.silverruler.xyz에 들어가 보면 복지 정보를 크롤링하는데, 크롤링을 수행하면 하루에 약 500개 정도의 글이 수집된다.
그 수많은 글 중에서 실질적으로 돈과 관련된 주요 article을 8개 추리고, 그것을 요약까지 해서 자동으로 Redis에 푸시하는 과정을 전부 로컬 LLM에게 시키고 있다. 🤖
또한 가끔 보고 싶은 해외 미드 중에 한글화 자막이 전혀 없는 경우:
- 먼저 Whisper로 영어 자막(SRT)을 추출해 내고,
- 그 후 로컬 LLM에게 한국어 자막으로 번역해 달라고 스크립트를 돌리면,
아주 상당한 수준의 매끄러운 자막 번역본을 얻을 수 있다. 👍
🔵 실전 테스트 : cURL 호출 및 모델 확인
이 정도로 각설하고 바로 사용 방법을 알아보자.
이미 지난 PART 2에서 Ollama 설치, 모델 빌드, 0.0.0.0 리스닝 개방까지 다 해둔 상태이므로, curl로 호출부터 잘 되는지 확인해 보자.
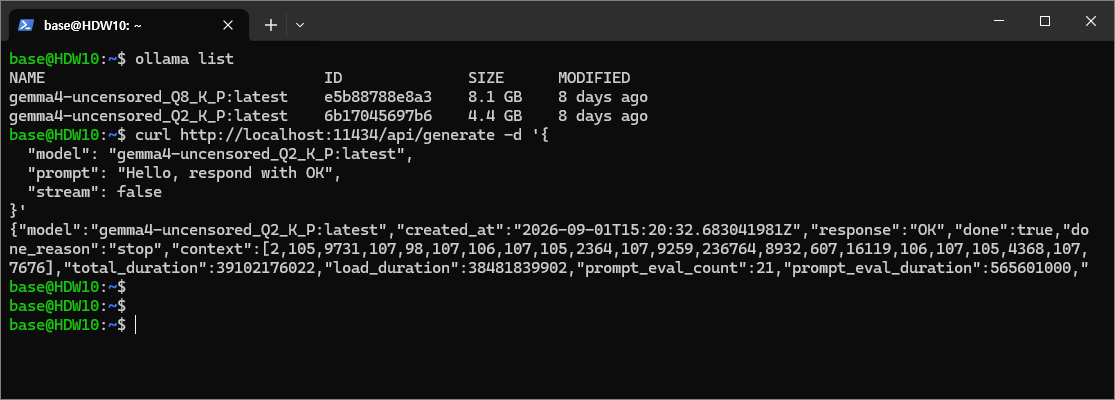
먼저 파워쉘 기반 터미널을 열고 WSL에 진입한 후 ollama list를 입력한다.
📋 WSL 터미널 ollama list 확인 (클릭하여 펼치기)
base@HDW10:~$ ollama list
NAME                               ID              SIZE      MODIFIED
gemma4-uncensored_Q8_K_P:latest    e5b88788e8a3    8.1 GB    8 days ago
gemma4-uncensored_Q2_K_P:latest    6b17045697b6    4.4 GB    8 days ago
base@HDW10:~$
서버맨은 이렇게 나오는데, 아마 지난 PART 2를 그대로 따라 한 사람은 모델명이 gemma-4-uncensored일 것이다. 모델명은 각자 자신이 빌드한 이름대로 적어주면 된다.
이제 확인용 curl 명령어를 날려보자.
📋 Ollama API cURL 호출 테스트 명령어 (클릭하여 펼치기)
curl http://localhost:11434/api/generate -d '{
  "model": "gemma4-uncensored_Q2_K_P:latest",
  "prompt": "Hello, respond with OK",
  "stream": false
}'
📋 cURL JSON 응답 결과 (클릭하여 펼치기)
{
  "model": "gemma4-uncensored_Q2_K_P:latest",
  "created_at": "2026-09-01T15:20:32.683041981Z",
  "response": "OK",
  "done": true,
  "done_reason": "stop",
  "context": [2,105,9731,107,98,107,106,107,105,2364,107,9259,236764,8932,607,16119,106,107,105,4368,107,7676],
  "total_duration": 39102176022,
  "load_duration": 38481839902,
  "prompt_eval_count": 21,
  "prompt_eval_duration": 565601000,
  "eval_count": 2,
  "eval_duration": 51667000
}처음 응답을 받을 때는 3~5분 정도 시간이 걸릴 수 있다. 기본적으로 모델을 VRAM에 계속 상주시켜 두고 있는 상태가 아니기 때문에, 처음 curl을 날리면 스토리징에서 VRAM으로 모델 가중치를 올리느라 시간이 좀 걸린다.
하지만 한 번 모델을 올리고 나서는 미사용으로 인해 모델이 자동으로 내려가기 전까지 매우 빠른 속도로 응답이 돌아온다!
사실 로컬호스트 11434 포트에서 응답이 온다면 이걸로 활용법 1의 기본 준비는 끝이다! 🎉
이제부터는 각자 어떻게 파이프라인을 짜느냐에 따라 무궁무진하다. 자막 번역이든 문서 요약이든 상용 웹 채팅 서비스에 파일 넣고 요청할 수도 있지만, 작업량이 방대해지면 이렇게 API를 직접 호출하는 방식이 압도적으로 빠르고 쿼터 한도가 뜰 일이 전혀 없다.
🐍 실전 예제 : 파이썬 SRT 자막 자동 번역 스크립트
예시 코드가 필요한 사람들을 위해 python3 translate.py 파일명.srt 형태로 실행하면 자막을 한 줄씩 읽어 한국어로 자동 번역 및 저장해 주는 번역 스크립트를 첨부한다.
📋 translate.py 전체 소스코드 보기 (클릭하여 펼치기)
#!/usr/bin/env python3

import sys
import re
import requests
from pathlib import Path


# ============================================================
# 설정
# ============================================================

SOURCE_LANGUAGE = 'japanese'
TARGET_LANGUAGE = 'korean'

OLLAMA_URL = 'http://localhost:11434/api/generate'
MODEL = 'gemma4-uncensored_Q2_K_P:latest'


# ============================================================
# 번역
# ============================================================

def translate(text):
    prompt = f"""Translate the following subtitle from {SOURCE_LANGUAGE} to {TARGET_LANGUAGE}.

Rules:
- Translate naturally, as if it were a real movie/anime subtitle.
- Preserve the original meaning and tone.
- Do not add explanations.
- Output ONLY the translated subtitle.
- Keep line breaks if possible.

Subtitle:
{text}
"""

    response = requests.post(
        OLLAMA_URL,
        json={
            "model": MODEL,
            "prompt": prompt,
            "stream": False,
        },
        timeout=600,
    )

    response.raise_for_status()

    return response.json()["response"].strip()


# ============================================================
# SRT 처리
# ============================================================

def translate_srt(input_file):
    text = Path(input_file).read_text(encoding='utf-8')

    # SRT 블록 분리
    blocks = re.split(r'\n\s*\n', text.strip())

    translated_blocks = []

    for i, block in enumerate(blocks, 1):
        lines = block.splitlines()

        # 번호 + 시간 + 대사 구조가 아니면 그대로 유지
        if len(lines) < 3 or '-->' not in lines[1]:
            translated_blocks.append(block)
            continue

        subtitle_text = '\n'.join(lines[2:]).strip()

        if not subtitle_text:
            translated_blocks.append(block)
            continue

        print(f'[{i}/{len(blocks)}] {subtitle_text}')

        translated = translate(subtitle_text)

        new_block = '\n'.join([
            lines[0],
            lines[1],
            translated
        ])

        translated_blocks.append(new_block)

        print(f'        → {translated}')

    output_file = Path(input_file).with_name(
        Path(input_file).stem + '_ko.srt'
    )

    output_file.write_text(
        '\n\n'.join(translated_blocks) + '\n',
        encoding='utf-8'
    )

    return output_file


# ============================================================
# Main
# ============================================================

def main():
    if len(sys.argv) != 2:
        print(f'사용법: python3 {Path(sys.argv[0]).name} 파일명.srt')
        sys.exit(1)

    input_file = sys.argv[1]

    if not Path(input_file).exists():
        print(f'파일을 찾을 수 없습니다: {input_file}')
        sys.exit(1)

    output_file = translate_srt(input_file)

    print()
    print(f'번역 완료: {output_file}')


if __name__ == '__main__':
    main()
🌐 활용법 2. OpenWebUI 연동 (나만의 사설 ChatGPT 웹 구축)
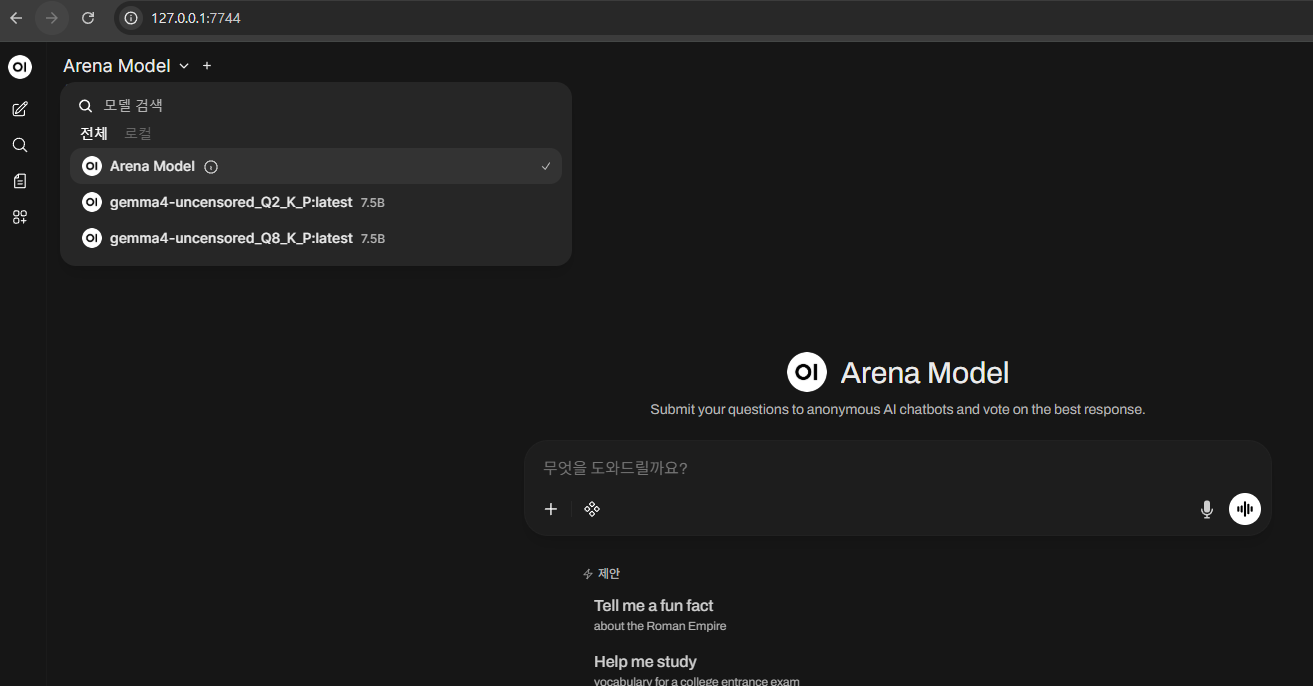
두 번째 활용법을 알아보자.
두 번째 방법은 로컬 LLM 모델에 OpenWebUI를 연동하는 것이다.
OpenWebUI는 우리가 흔히 사용하는 ChatGPT처럼 세련된 웹 채팅 UI 서비스를 내 로컬 서버에 직접 구축하는 솔루션이다.
앞 단계에서 이미 curl로 Ollama 동작 확인이 끝났다면 구축은 정말 1분 컷으로 간단하다. 도커(Docker Compose)로 한 방에 띄울 수 있다. 🐳
📋 docker-compose.yml 설정 내용 보기 (클릭하여 펼치기)
services:
  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: open-webui
    restart: no
    ports:
      - "7744:8080"
    environment:
      - OLLAMA_BASE_URL=http://host-gateway:11434
    volumes:
      - open-webui-data:/app/backend/data
    extra_hosts:
      - "host-gateway:host-gateway"

volumes:
  open-webui-data:
서버맨은 편의상 외부 포트를 7744 포트로 매핑했다. 당연하게도 컨테이너 내부 포트인 뒤의 8080은 건드리면 안 된다.
우분투(Ubuntu) 특성상 iptables이나 ufw 방화벽을 따로 빡빡하게 설정하지 않았다면 기본값은 모든 포트 개방(All Port)이므로,
docker compose up -d를 실행하여 컨테이너를 백그라운드로 부팅시키고,- 호스트 윈도우에서 크롬 브라우저를 열어
http://127.0.0.1:7744로 접속하면 사진과 같이 깔끔하고 예쁜 웹 채팅 인터페이스가 즉시 열린다! ✨
🦞 활용법 3. 개인 AI 비서 OpenClaw 연동 (메신저로 LLM 부리기)
세 번째 활용은 한때 전 세계 개발 커뮤니티를 떠들썩하게 만들었던 개인 AI 비서 OpenClaw이다!
사실 OpenClaw도 구글의 Antigravity CLI 2.0이나 앤트로픽의 Claude Code, OpenAI의 Codex처럼 터미널에서 코딩을 대신해 주는 강력한 AI 에이전트와 동일한 구조다 (openclaw tui).
그런데 굳이 '비서'라는 이름이 붙은 결정적인 이유는, 다양한 모바일 메신저에 연동이 가능하고 핸드폰에서 메신저로 톡을 보내 명령을 내리면 백그라운드에서 알아서 작업을 척척 수행하기 때문이다. 📱
💰 상용 API vs 로컬 LLM 연동 : 맥미니 M4 품귀 현상의 진실
물론 OpenClaw에 상용 프론티어 LLM 회사들의 유료 API 키를 연동해서 쓸 수도 있다.
하지만 그렇게 쓰면 실시간으로 토큰이 갈려 나가면서 아마 무시무시한 요금 폭탄 💸이 발생할 것이다. 반면 개인 컴퓨터나 홈 서버를 켜두고 로컬 LLM을 API로 연동하면 요금 부담이 전혀 없이 24시간 풀가동할 수 있다.
🛠️ OpenClaw 및 NVM 설치하기
OpenClaw를 설치하기 전에 먼저 Node.js와 npm을 설치해야 한다. 버전 관리를 편하게 해주는 NVM을 먼저 깔아주자.
📋 NVM 및 Node LTS 설치 명령어 (클릭하여 펼치기)
curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.39.7/install.sh | bash
source ~/.bashrc
nvm install --lts
nvm use --lts
설치 후 npm -v를 입력하여 정상적으로 버전 숫자가 출력되면 Node 환경 구축 완료다.
이제 아래 명령어로 OpenClaw를 글로벌로 설치한다:
npm install -g openclaw
설치 완료 후 openclaw -h를 입력해 보면 다음과 같은 사용 예시 목록이 나타난다.
📋 openclaw -h 명령어 예시 목록 (클릭하여 펼치기)
Examples:
  openclaw onboard
    Run guided setup for a local Gateway, workspace, auth, and channels.
  openclaw setup
    Create the baseline config, workspace, and session folders.
  openclaw configure
    Change models, Gateway, channels, plugins, skills, and health checks.
  openclaw status
    Check Gateway, channel, model, and recent-session status.
  openclaw doctor --fix
    Repair common config, service, plugin, and channel problems.
  openclaw channels add
    Add or update a chat channel account with guided prompts.
  openclaw channels status
    See connected messaging accounts and login state.
  openclaw --dev gateway
    Run a dev Gateway (isolated state/config) on ws://127.0.0.1:19001.
  openclaw gateway run --force
    Start the Gateway and replace anything bound to its port.
  openclaw models status
    Show model/provider auth health before running agents.
  openclaw plugins list
    Inspect enabled, disabled, and installed plugins.
  openclaw agent --to +15555550123 --message "Run summary" --deliver
    Run one agent turn through the Gateway and optionally deliver the reply.
  openclaw message send --channel telegram --target @mychat --message "Hi"
    Send via your Telegram bot.

Docs: docs.openclaw.ai/cli
⚙️ OpenClaw 모델 설정 (Ollama 연동)
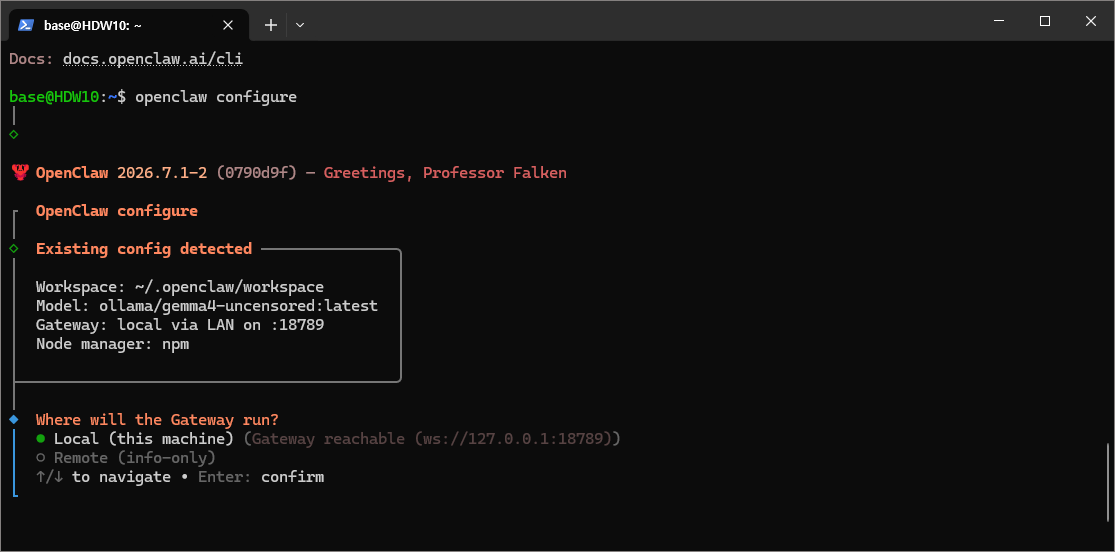
예전 버전에서는 openclaw onboard를 치면 마법사 방식으로 순서대로 설정할 수 있었으나,
최근 업데이트가 되었으므로 터미널에 openclaw configure를 입력한다.
화면에 나오는 메뉴를 차례대로 선택해 주면 된다:
1. Local 선택
2. Model 선택
3. More... 을 눌러 Ollama 선택
4. Ollama Cloud가 아닌 일반 Ollama 선택
5. Ollama + Local 선택
6. Base URL은 기본값으로 적혀있는
http://127.0.0.1:11434 선택7. Ollama에 등록된 모델 목록이 불러와지면, 자신이 사용할 로컬 모델 선택
💬 메신저 채널 연동 (텔레그램 / 디스코드)
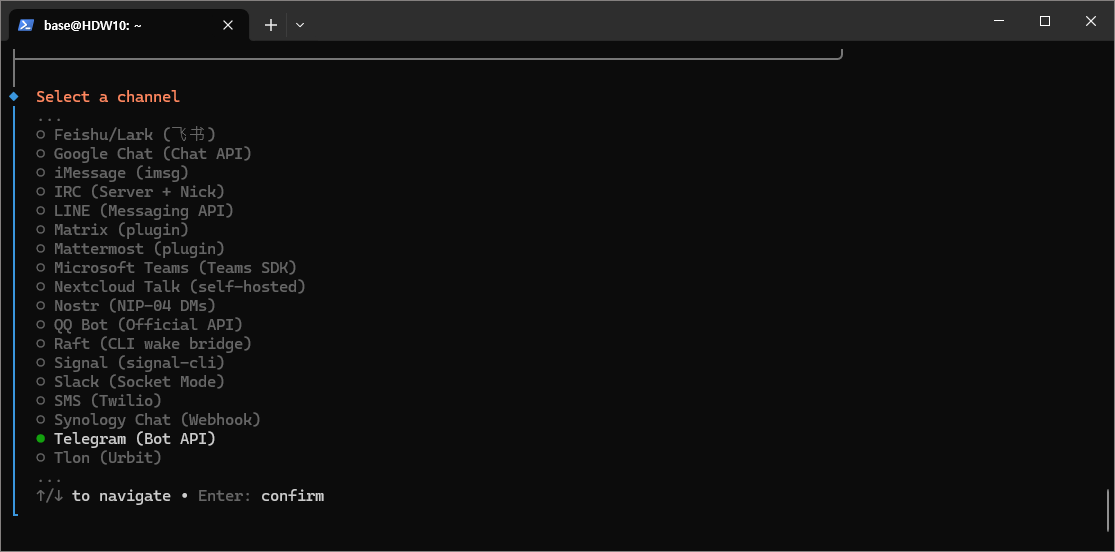
이제 두 번째로 내 스마트폰과 대화할 메신저 채널을 선택해야 한다.
다시 openclaw configure 메뉴 창으로 돌아와서:
- Channels 선택
- Add or update channels 선택
| 메신저 플랫폼 | 연동 방식 | 특징 및 추천 여부 |
|---|---|---|
| ✈️ Telegram | Bot API | 강력 추천! BotFather를 통해 1분 만에 토큰 발급 가능, 가장 깔끔함 |
| 👾 Discord | Bot API | 강력 추천! 개인 디스코드 서버에 봇 추가하여 채널별 관리 용이 |
| 💼 Slack | Socket Mode | 업무용 워크스페이스 연동 시 유용 |
| QR Link | QR 코드 스캔으로 간편 연동 | |
| 🟢 Line | Messaging API | 비추천. 개발자 센터 등록 및 승인 절차가 매우 번거로움 |
라인(Line)은 서버맨이 직접 시도해 본 결과 개발자 페이지에서 요구하는 등록 과정이 너무 복잡하고 번거로웠다. 가장 심플하게 토큰만 넣고 끝낼 수 있는 Telegram이나 Discord를 강력 추천한다.
@BotFather에게 채팅을 걸어 /newbot만 치면 바로 발급된다. 구글에 검색하거나 LLM에게 물어보면 10초 만에 나온다!📱 실전 테스트 : 텔레그램으로 내 AI 비서 부리기
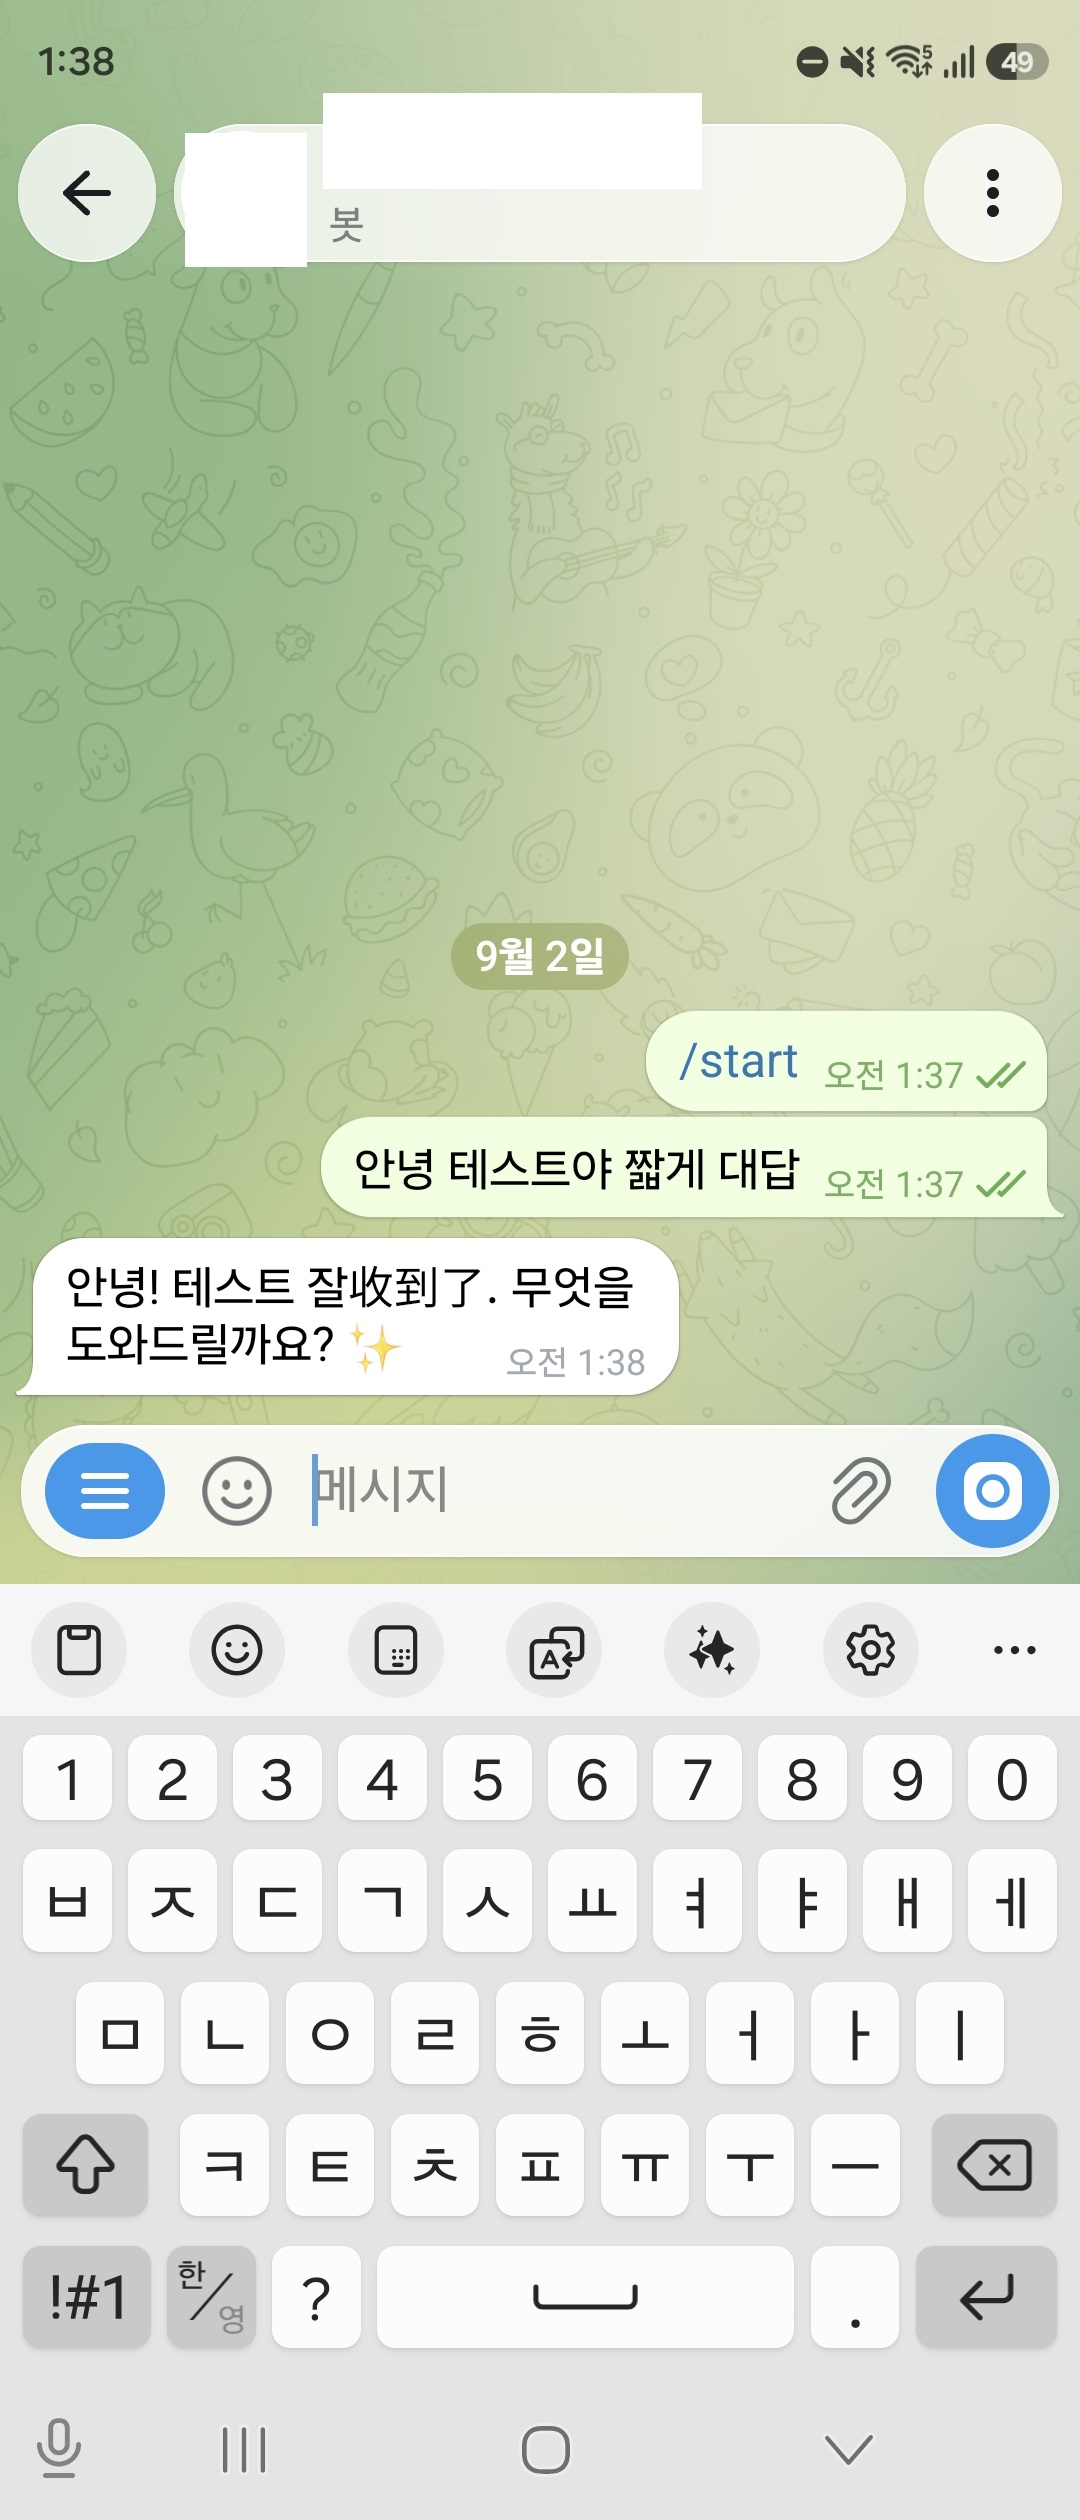
서버맨의 경우 텔레그램으로 연동을 완료했다.
핸드폰을 켜고 생성된 텔레그램 봇 채팅방에 메시지를 날리면 실시간으로 즉각 답변이 도착한다!
채팅창에서 *"이 파이썬 스크립트 리팩토링해 줘"* 라고 하거나, *"인터넷 검색해서 최신 AI 뉴스 3개만 요약해 와"* 라고 지시를 내리면, 모델 성능에 따라 약간의 디테일 차이는 있겠지만 혼자서 백그라운드 툴을 호출하고 자료를 찾아와서 척척 비서 역할을 완벽하게 해낸다. 👏
📝 마무리 : 소버린 AI 생태계의 완성
1️⃣ PART 1 : 왜 우리에게 자체 인프라와 GPU 기반의 소버린 AI (Sovereign AI)가 필요한지 이해했다.
2️⃣ PART 2 : Ollama와 검열이 해제된 고성능 언센서드 Gemma 4를 내 로컬 머신에 완벽하게 빌드하고 포트를 개방했다.
3️⃣ PART 3 : 구축된 로컬 LLM을 기반으로 한도 없는 API 자동화, 사설 OpenWebUI 챗봇, 그리고 스마트폰 메신저 연동 AI 비서 OpenClaw까지 실전 구축을 완료했다!
• 비용 제로 (0원): 매달 나가는 구독료와 API 청구서 걱정 끝!
• 무제한 쿼터: 수만 줄의 코드 리뷰, 대량 자막 번역도 24시간 멈춤 없이 가동!
• 100% 프라이버시: 민감한 회사 코드나 개인 데이터가 외부 빅테크 서버로 전송되지 않는 완벽한 보안!
다음 포스팅에서는 LLM에게 진짜 날개를 달아주는
'AI의 도구 사용법' — MCP (Model Context Protocol), Skills, 그리고 Plugins 심화 세팅 혹은
' 무료 AI 라우팅 모델 서비스 ' — OmniRoute, 9Router 사용법에 대해 알아보겠다. 🚀
질문은 언제나 환영 🙌
🛰️ 서버맨의 공간들
'Local AI > Ollama' 카테고리의 다른 글
| [AI] AI와 GPU 그리고 Local LLM (소버린 AI) PART 2 (0) | 2026.08.10 |
|---|---|
| [AI] AI와 GPU 그리고 Local LLM(소버린 AI) - PART 1 (0) | 2026.07.20 |

